

FLOPS для нейросетей: сколько вычислений нужно модели и как собрать нужную мощность
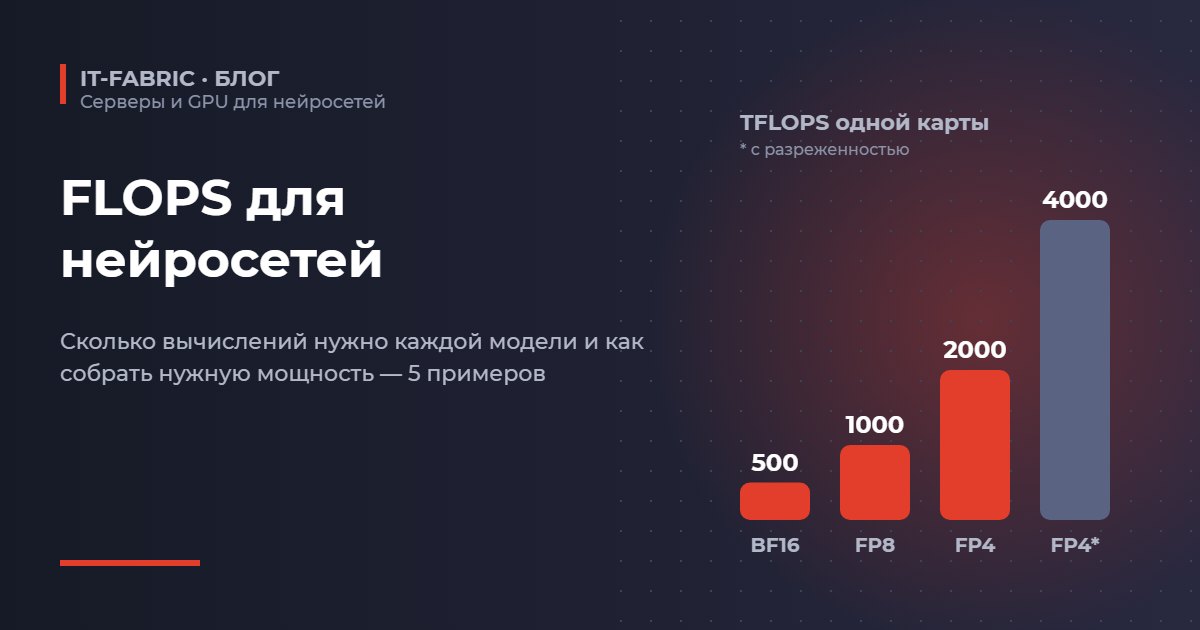
Что такое TFLOPS и почему цифры в спецификациях завышены, формулы расчёта для инференса и обучения, таблица для популярных моделей и пять примеров со сборками — от самой дешёвой до промышленной.
Сколько вычислительной мощности на самом деле нужно нейросети, почему маркетинговые «4 петафлопса» не равны реальным, как перевести задачу клиента в терафлопсы и какими способами — от максимально дешёвого до промышленного — эту мощность можно собрать. Пять разобранных примеров с расчётами.
1. Что такое FLOPS и почему цифры в спецификациях обманчивы
FLOPS (floating point operations per second) — количество операций с плавающей точкой в секунду. Для нейросетей используют приставки: 1 TFLOPS = 1012 операций в секунду, 1 PFLOPS = 1000 TFLOPS. Одна и та же видеокарта выдаёт разное число FLOPS в зависимости от точности вычислений:
| Точность | Бит | Где применяется | Соотношение скоростей на современных GPU |
|---|---|---|---|
| FP32 / TF32 | 32 | Научные расчёты, старые модели | ×0,5 от BF16 (TF32) или ещё меньше |
| BF16 / FP16 | 16 | Обучение, дообучение, эталонный инференс | ×1 — базовая величина |
| FP8 | 8 | Промышленный инференс, частично обучение | ×2 |
| FP4 (NVFP4, MXFP4) | 4 | Инференс на Blackwell (RTX PRO 6000, RTX 50, B200/B300) | ×4 |
Производители публикуют максимальную цифру — в самой низкой точности и с разреженностью (sparsity 2:4), которая даёт удвоение только на специально подготовленных моделях и на практике почти не используется. Так получаются «AI TOPS» и «петафлопсы» на коробке.
Пример: NVIDIA RTX PRO 6000 Blackwell (600 Вт). Одна карта — четыре разные «мощности» в зависимости от того, как считать.
Шкала: реальные (плотные) FP8 TFLOPS популярных карт
Для GeForce — с FP32-накоплением, то есть то, что реально получают PyTorch, vLLM и llama.cpp. Для RTX 3090 и MI50 FP8 нет: их BF16/FP16 — 71 и 26,5 TFLOPS. Источники: спецификации NVIDIA и AMD.
 GeForce RTX 5090~419 TFLOPS FP8 · 32 ГБ
 Radeon AI PRO R9700~383 TFLOPS FP8 · 32 ГБ
 RTX PRO 6000 Server Edition~1000 TFLOPS FP8 · 96 ГБ
 NVIDIA H200 NVL~1671 TFLOPS FP8 · 141 ГБ
2. Главные формулы: сколько FLOP тратит модель
Обучение «с нуля» или полное дообучение: ≈ 6 × N × D
Дообучение LoRA: ≈ 4 × N × D (без градиентов по основным весам)
Nакт — активные параметры (у MoE — только активные), N — все обучаемые параметры, D — число токенов в обучающих данных
Реальная загрузка GPU всегда ниже пиковой. Долю пиковой мощности, которую удаётся использовать, называют MFU (model FLOPS utilization):
| Режим | Типичная доля пика (MFU) | Что значит для расчёта |
|---|---|---|
| Чтение длинных запросов (prefill), пакетная обработка | 40–60 % | Делим требуемые TFLOPS на 0,4–0,5 |
| Генерация ответа одному пользователю | 1–5 % | TFLOPS почти не важны — решает пропускная способность памяти |
| Генерация для 50–200 пользователей сразу | 20–40 % | Чем больше пакет, тем полезнее TFLOPS |
| Обучение / дообучение на нескольких GPU | 30–45 % | Ниже на картах без NVLink и на игровых GPU |
3. Сколько FLOP нужно популярным моделям
Ниже — вычисления на обработку 1000 токенов (примерно 700 слов на русском) без учёта внимания. На очень длинных контекстах (64K+) механизм внимания добавляет ещё 10–50 %.
4. Когда FLOPS важны, а когда нет
| Задача | Главный ресурс | Роль TFLOPS |
|---|---|---|
| Чат с 1–5 пользователями, короткие вопросы | Пропускная способность памяти | низкая — хватит любой современной карты |
| Поиск по документам (RAG): в запрос подставляются 5–30 тыс. токенов текста | TFLOPS + память под кеш | высокая — определяет время до первого слова |
| Отдел или компания: 50–500 одновременных запросов | TFLOPS + объём памяти | высокая |
| Агенты для программистов: контекст 50–200 тыс. токенов | TFLOPS + память | очень высокая |
| Пакетная обработка архива (суммаризация, классификация) | TFLOPS | определяет срок выполнения |
| Дообучение и обучение | TFLOPS + связь между GPU | определяет срок выполнения |
5. Пять примеров: от задачи к терафлопсам и к железу
Во всех примерах учитываем реальную загрузку GPU (MFU 40 %), FLOPS берём плотные. Цены — ориентир по рынку РФ на ноябрь 2026 года, подробная таблица — в статье «Самые дешёвые TFLOPS в России».
Пример 1. Внутренний чат-ассистент на 300 сотрудников
Задача: модель Qwen3.8-27B, в пиковый час 1 запрос в секунду; запрос — 3000 токенов (системные инструкции, история, справка), из них 1500 повторяются и берутся из кеша; ответ — 500 токенов.
Ответ: 2 × 27 млрд × 500 = 27 TFLOP
Итого 108 TFLOP на запрос × 1 запрос/с = 108 TFLOPS полезных ÷ 0,4 = ~270 TFLOPS пиковых (FP8)
Память: 28 ГБ весов (FP8) + кеш на 30 одновременных диалогов ≈ 50–70 ГБ
| Сборка | FP8 TFLOPS | Память | Вывод | Ориентир по картам |
|---|---|---|---|---|
| Максимально дёшево: 2 × Radeon AI PRO R9700 | ~766 | 64 ГБ | Хватает по расчёту, но ПО под AMD требует проверки на конкретной модели | ~0,5 млн ₽ |
| Дёшево на NVIDIA: 2 × RTX 5090 в рабочей станции | ~838 | 64 ГБ | Запас ×3, быстрая генерация; нет серверной гарантии | ~1,3–1,5 млн ₽ |
| Оптимально: 1 × RTX PRO 6000 Server Edition | ~1000 | 96 ГБ | Одна карта, запас по памяти, можно добавить вторую | ~2,7 млн ₽ |
2 × Radeon AI PRO R9700максимально дёшево
2 × RTX 5090дёшево на NVIDIA
1 × RTX PRO 6000 Server Editionоптимально
Пример 2. Поиск по базе документов (RAG) на 1000 сотрудников
Задача: модель gpt-oss-120b, в пике 2 запроса в секунду, в каждый подставляется 12 тыс. токенов найденных документов, ответ — 800 токенов.
Ответ: 2 × 5,1 млрд × 800 ≈ 8 TFLOP
× 2 запроса/с = 310 TFLOPS полезных ÷ 0,4 = ~780 TFLOPS пиковых
Память: 63 ГБ весов + кеш на 40 одновременных запросов по 13 тыс. токенов ≈ 85–100 ГБ
| Сборка | FP8 TFLOPS | Память | Вывод |
|---|---|---|---|
| Максимально дёшево: 4 × Radeon AI PRO R9700 | ~1530 | 128 ГБ | ~0,95 млн ₽ за карты — запас ×2 по вычислениям; работу gpt-oss на ROCm проверяем на пилоте |
| Минимум на NVIDIA: 1 × RTX PRO 6000 | ~1000 | 96 ГБ | Впритык и по вычислениям, и по памяти — в пике возможны очереди |
| Оптимум: 2 × RTX PRO 6000 | ~2000 | 192 ГБ | Запас ×2,5 по вычислениям, место под рост базы |
| Альтернатива: 1 × H200 NVL | ~1670 | 141 ГБ | Быстрее генерирует ответ (4,8 ТБ/с), дороже за терафлопс |
4 × Radeon AI PRO R9700128 ГБ · ~0,95 млн ₽ за карты
2 × RTX PRO 6000оптимум: 192 ГБ
1 × H200 NVLбыстрая генерация, 141 ГБ
Пример 3. ИИ-агенты для 40 программистов
Задача: DeepSeek V4 Flash, каждый разработчик — около 4 запросов агента в минуту. Контекст 60 тыс. токенов, но 90 % берётся из кеша, новых — 6000 токенов, ответ — 1000 токенов.
÷ 0,4 = ~1,6 PFLOPS пиковых (FP8)
Память: ~160 ГБ весов + 80–150 ГБ под кеш длинных контекстов = 250–300 ГБ
| Сборка | FP8 PFLOPS | Память | Вывод |
|---|---|---|---|
| Бюджетно: 8 × Radeon AI PRO R9700 | ~3,1 | 256 ГБ | Дёшево (~2 млн ₽ за карты), но поддержка новых механизмов внимания DeepSeek V4 на AMD появляется с задержкой — нужен пилот |
| Оптимально: 4 × RTX PRO 6000 Server Edition | ~4,0 | 384 ГБ | Запас ×2,5, проверенный стек NVIDIA |
| Быстрее всего отвечает: 2 × H200 NVL | ~3,3 | 282 ГБ | Максимальная скорость генерации, но память впритык — лучше 4 карты |
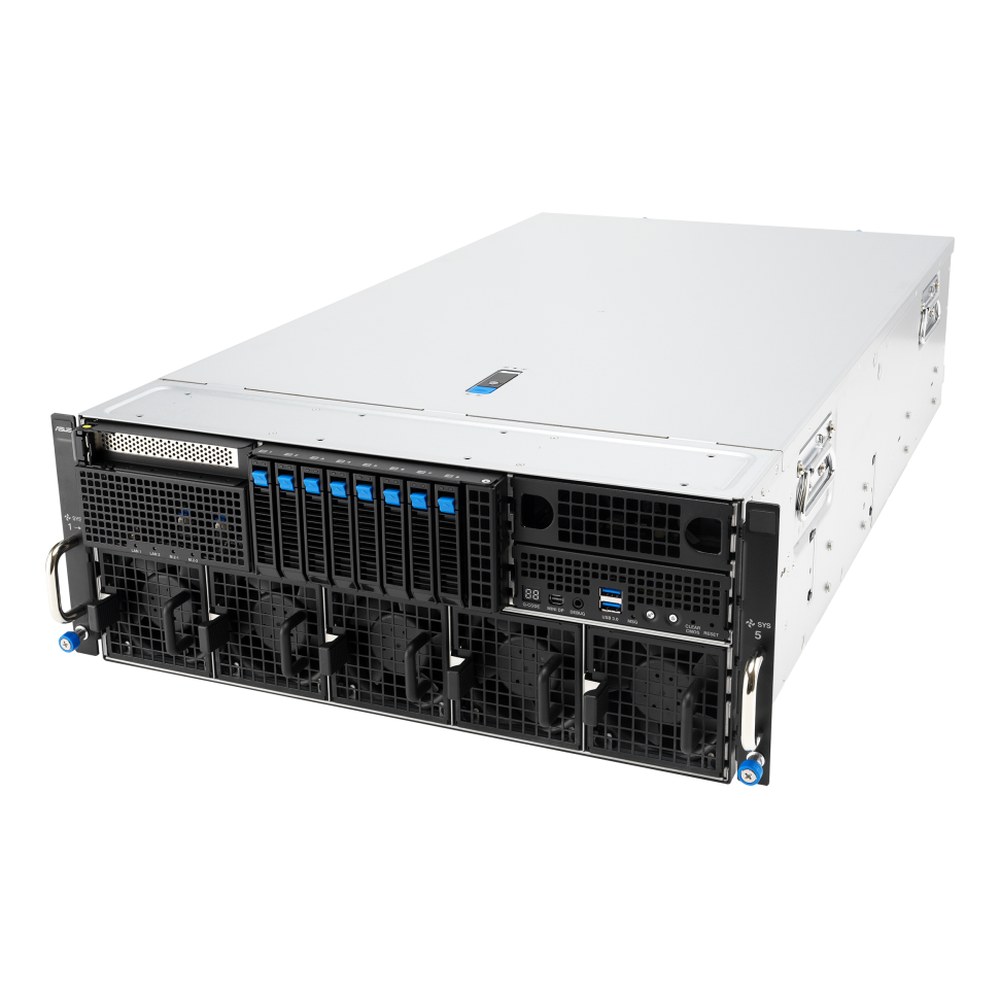 Сервер 4U на 8 GPUASUS ESC8000A-E13P: под 8 × R9700 или 4–8 × RTX PRO 6000
4 × RTX PRO 6000 Server Editionоптимально: 384 ГБ, ~4 PFLOPS
Пример 4. Обработка архива: 2 млн документов
Задача: суммаризировать 2 млн документов по 4000 токенов (ответ — 300 токенов). Пакетная задача: важна не скорость отдельного ответа, а срок обработки всего архива.
gpt-oss-20b: 2 млн × 2 × 3,6 млрд × 4300 = 6,2 × 10¹⁹ FLOP — в 7,5 раза меньше
| Железо (загрузка 40–45 %) | Qwen3.8-27B | gpt-oss-20b |
|---|---|---|
| 8 × RTX 3090 б/у (BF16) | ~24 дня | ~3 дня |
| 3 × Radeon AI PRO R9700 (FP8), ~0,7 млн ₽ | ~12 дней | ~1,6 дня |
| 2 × RTX 5090 (FP8) | ~16 дней | ~2 дня |
| 1 × RTX PRO 6000 (FP8) | ~12 дней | ~1,6 дня |
| 4 × RTX PRO 6000 (FP8) | ~3 дня | ~10 часов |
| 8 × H200 NVL (FP8) | ~21 час | ~3 часа |
Пример 5. Дообучение и обучение
Дообучение LoRA модели Qwen3.8-27B на 200 млн токенов корпоративных данных (несколько проходов по базе знаний):
| Железо | Режим | Время |
|---|---|---|
| 2 × RTX 3090 б/у | QLoRA (4-битная модель) | ~5 суток |
| 1 × RTX 5090 | QLoRA | ~3,5 суток |
| 1 × RTX PRO 6000 | LoRA в BF16 | ~30 часов |
| 4 × RTX PRO 6000 | LoRA в BF16 | ~8 часов |
| 8 × H200 NVL | LoRA в BF16 | ~2 часа |
Обучение небольшой модели с нуля (1,5 млрд параметров на 30 млрд токенов — например, отраслевая модель для классификации): 6 × 1,5 млрд × 30 млрд = 2,7 × 10²⁰ FLOP. Это ~16 суток на 8 × RTX 3090, ~7 суток на 8 × R9700, ~4 суток на 4 × RTX PRO 6000 и около суток на 8 × H200 NVL. Обучение крупных моделей с нуля (десятки миллиардов параметров на триллионах токенов) требует 1023–1024 FLOP — это кластеры из сотен GPU, и бизнесу почти всегда выгоднее дообучать готовую открытую модель.
6. Самая дешёвая и оптимальная сборка под каждый случай
Сведём примеры в одну таблицу. «Максимально дёшево» — минимальная цена карт, которая закрывает расчётные TFLOPS и память, пусть даже с компромиссами по ПО, гарантии и шуму. «Оптимально» — то, что мы предлагаем для промышленной эксплуатации. Цены — только карты, по середине рыночного диапазона на ноябрь 2026 года.
| Случай | Нужно, FP8 TFLOPS | Нужно памяти | Максимально дёшево | Дёшево на NVIDIA | Оптимально |
|---|---|---|---|---|---|
| 1. Чат на 300 сотрудников (Qwen3.8-27B) | ~270 | 50–70 ГБ | 2 × R9700 — ~0,47 млн ₽ | 2 × RTX 5090 — ~1,4 млн ₽ | 1 × RTX PRO 6000 SE — ~2,7 млн ₽ |
| 2. RAG на 1000 сотрудников (gpt-oss-120b) | ~780 | 85–100 ГБ | 4 × R9700 — ~0,95 млн ₽ | 1 × RTX PRO 6000 Max-Q — ~2,2 млн ₽ | 2 × RTX PRO 6000 SE — ~5,4 млн ₽ |
| 3. Агенты для 40 программистов (DeepSeek V4 Flash) | ~1600 | 250–300 ГБ | 8 × R9700 — ~1,9 млн ₽ | 4 × RTX PRO 6000 Max-Q — ~8,8 млн ₽ | 4 × RTX PRO 6000 SE — ~10,8 млн ₽ |
| 4. Архив 2 млн документов (gpt-oss-20b) | по сроку | от 16 ГБ | 8 × RTX 3090 б/у — ~0,95 млн ₽, ~3 дня | 2 × RTX 5090 — ~1,4 млн ₽, ~2 дня | 1 × RTX PRO 6000 SE — ~2,7 млн ₽, ~1,6 дня |
| 5. LoRA-дообучение Qwen3.8-27B | по сроку | от 24 ГБ (QLoRA) | 2 × RTX 3090 б/у — ~0,24 млн ₽, ~5 суток | 1 × RTX 5090 — ~0,75 млн ₽, ~3,5 суток | 1 × RTX PRO 6000 — 2,2–2,7 млн ₽, ~30 часов |
7. Итоговая шпаргалка
Какие модели на каком железе работают — в обзоре «Какое железо нужно популярным нейросетям». Как подобрать карты и платформу под получившиеся цифры, мы разбираем в статье «Как собрать сервер для нейросети», а пример полного расчёта для коммерческого предложения — в разборе запроса клиента.
Опишите модель, число пользователей и тип запросов — подготовим расчёт и 2–3 варианта оборудования.
Локальная нейросеть под ключАренда GPU