

Какое железо нужно популярным нейросетям в 2026 году: минимум, оптимум и бюджет
Справочник по железу для LLM (GigaChat, Qwen, DeepSeek, gpt-oss), генерации изображений и видео (FLUX.2, Qwen-Image, Wan 2.2), распознавания речи и компьютерного зрения: минимальная, бюджетная и оптимальная конфигурация, ориентиры скорости и замены.
Справочник для подбора оборудования под конкретную нейросеть: языковые модели (LLM), генерация изображений и видео, распознавание речи, эмбеддинги для поиска по документам и компьютерное зрение. Для каждой модели — три уровня железа: минимальный, бюджетный и оптимальный, ориентир по скорости и объяснение, почему так и чем можно заменить. Данные на ноябрь 2026 года.
1. Как читать таблицы: минимум, бюджет, оптимум
Почему уровни именно такие: модели нужна память (влезет или нет), пропускная способность памяти (скорость печати ответа) и вычисления (скорость чтения длинных запросов и число пользователей). Как это посчитать самому — в статьях «Как собрать сервер для нейросети» и «FLOPS для нейросетей», цены на железо — в статье «Самые дешёвые TFLOPS в России».
2. Лестница оборудования: что на каком уровне работает
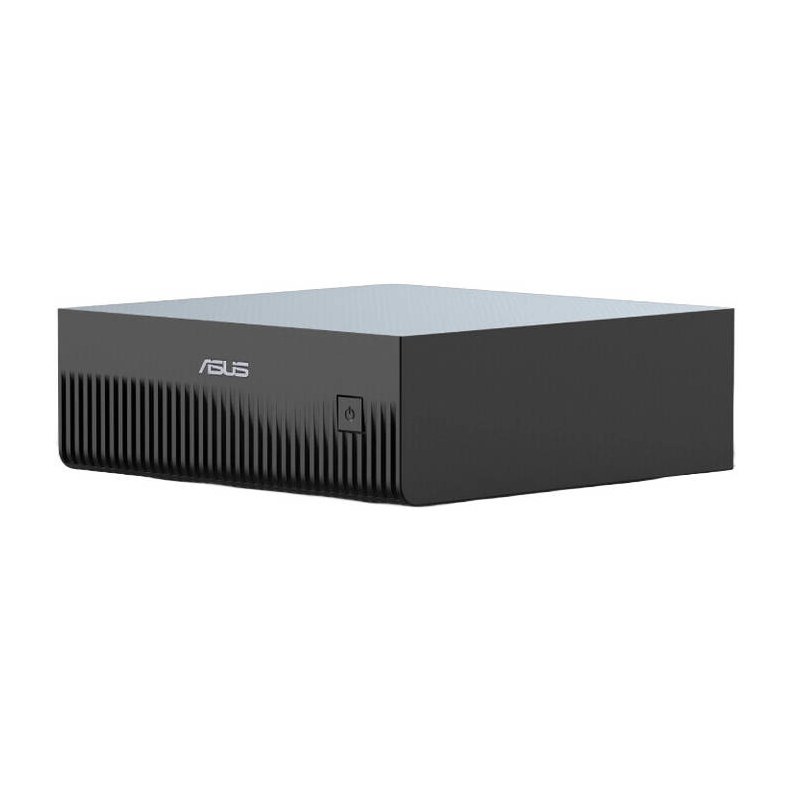 ASUS GX10 (NVIDIA GB10)уровень 2: 128 ГБ, CUDA
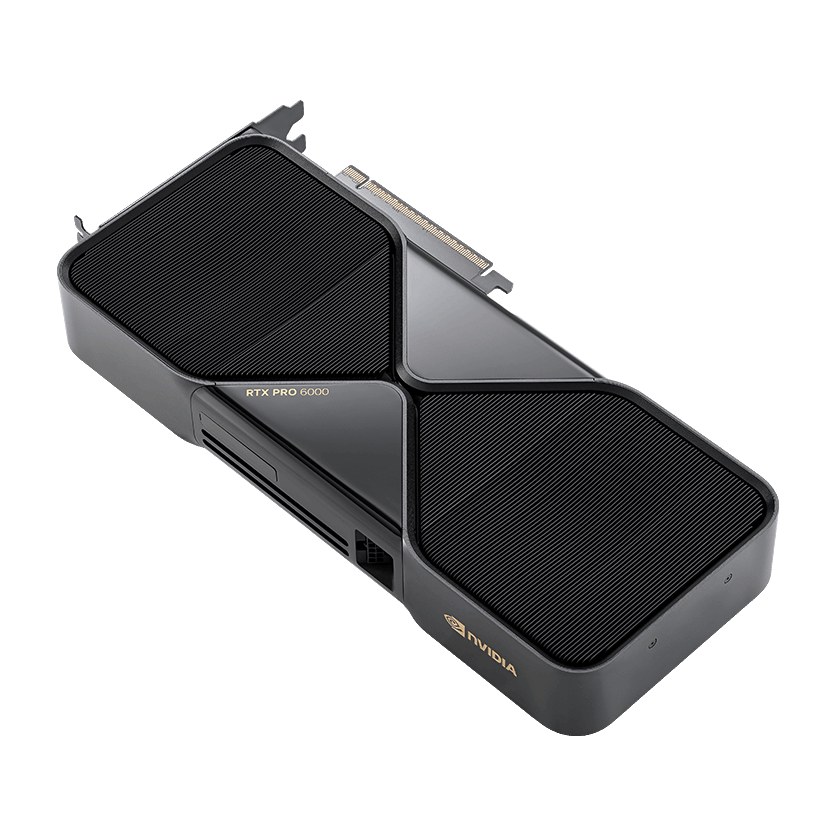 RTX PRO 6000 Workstationуровень 3: 96 ГБ в рабочей станции
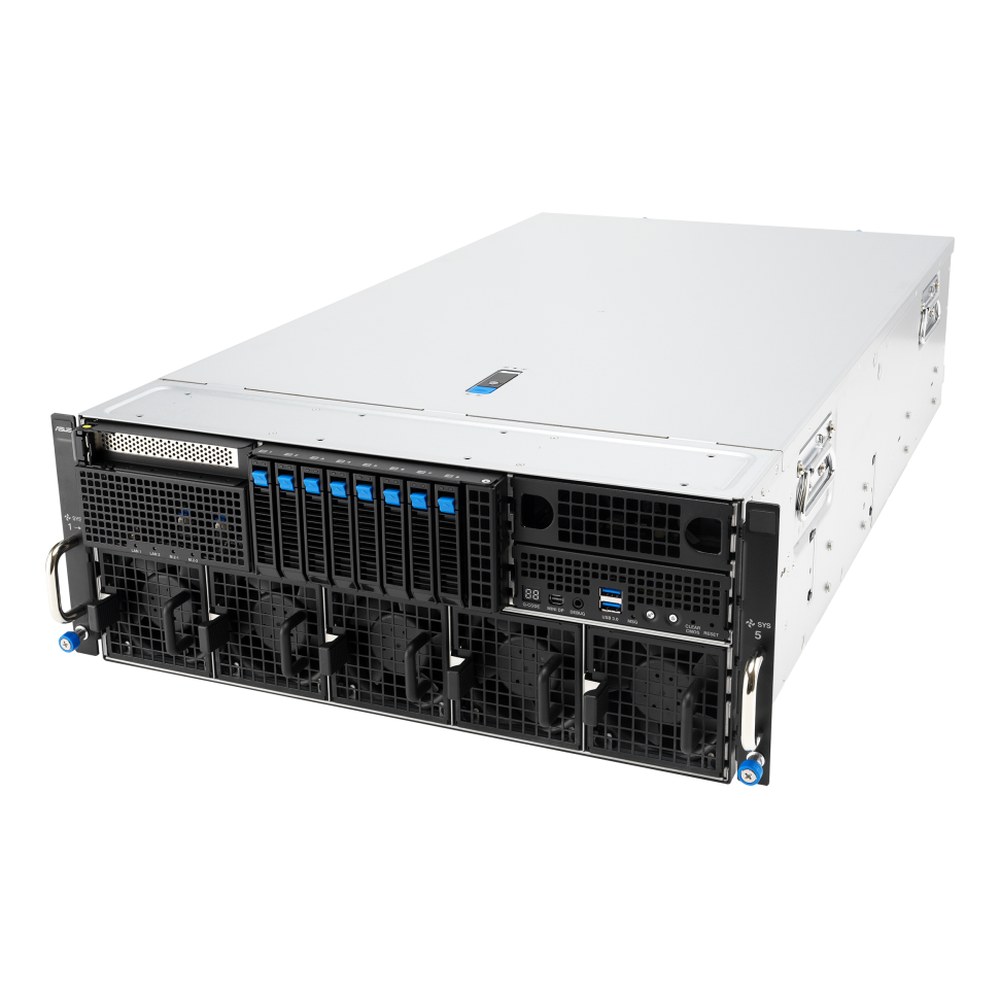 ASUS ESC8000A-E13Pуровни 4–5: 4U на 8 GPU
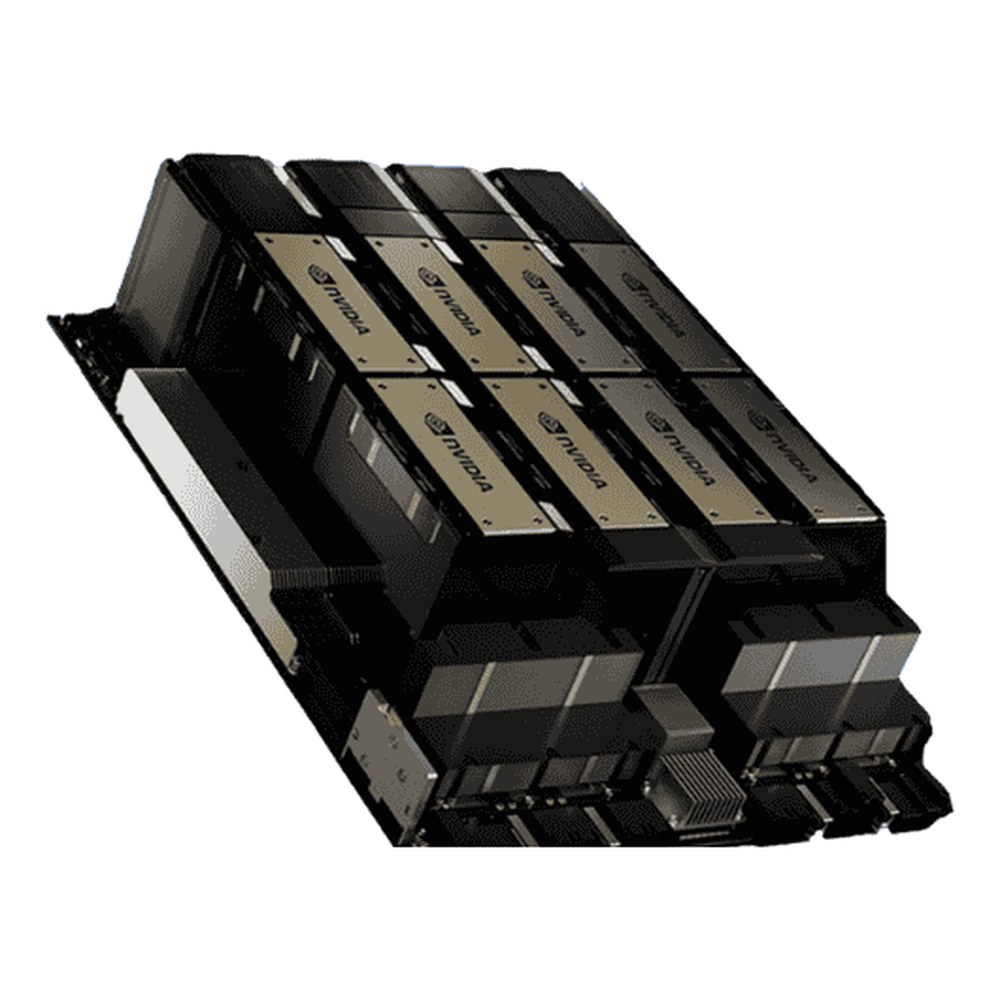 Плата HGX на 8 GPUуровень 6: модули SXM
3. Языковые модели (LLM)
Самые востребованные у наших клиентов открытые модели с лицензиями Apache 2.0 или MIT, которые разрешают коммерческое использование. Параметры — по карточкам моделей на Hugging Face. Объём памяти указан с учётом кеша для умеренного контекста.
| Модель | Параметры (всего / активно) | Минимум | Бюджет | Оптимум | Почему так |
|---|---|---|---|---|---|
| GigaChat 3.1 Lightning (Сбер) | 10 / 1,8 млрд, MoE | мин 1 × RTX 5060 Ti 16 ГБ (FP8) | бюджет мини-ПК на Ryzen AI Max+ 395 | оптимум 1 × RTX PRO 4500 32 ГБ или RTX 5090 | Весит 10 ГБ в FP8, активных параметров мало — быстрая даже на недорогих картах; хороша для русского языка |
| gpt-oss-20b (OpenAI) | 21 / 3,6 млрд, MoE | мин 1 × RTX 5060 Ti 16 ГБ | бюджет 1 × б/у RTX 3090 24 ГБ | оптимум 1 × RTX 5090 / RTX PRO 4500 | Выпущена сразу в 4 битах (MXFP4), ~13 ГБ; запас памяти уходит под контекст и пользователей |
| Qwen3.8-27B, Gemma 4 31B, T-Pro 2.1 | 27–33 млрд, плотные | мин 1 × RTX 5090 (4 бита) | бюджет 2 × б/у RTX 3090 или 2 × R9700 | оптимум 1 × RTX PRO 6000 96 ГБ (FP8) | Каждый токен читает все веса: важна скорость памяти. FP8 + кеш на 30 диалогов = 50–70 ГБ |
| gpt-oss-120b (OpenAI) | 117 / 5,1 млрд, MoE | мин мини-ПК 128 ГБ (GB10, Ryzen AI Max+ 395) | бюджет 4 × Radeon AI PRO R9700 (128 ГБ) | оптимум 1–2 × RTX PRO 6000 или 1 × H200 NVL | 63 ГБ в родном 4-битном формате; малое число активных параметров — высокая скорость |
| Qwen3.5-122B-A10B | 122 / 10 млрд, MoE | мин 1 × RTX PRO 6000 (4 бита) | бюджет 4 × R9700 (4 бита) | оптимум 2 × RTX PRO 6000 (FP8) | 124 ГБ в FP8 не помещаются в одну карту 96 ГБ |
| DeepSeek V4 Flash | 284 / 13 млрд, MoE | мин 2 × RTX PRO 6000, короткий контекст | бюджет 8 × R9700 (256 ГБ) | оптимум 4 × RTX PRO 6000 или 2–4 × H200 NVL | ~160 ГБ в родном формате; контекст до 1 млн токенов требует запаса под кеш |
| GLM-5.3-Flash, Qwen3.5-397B-A17B | 320–397 / 17–18 млрд, MoE | мин 4 × RTX PRO 6000 (4 бита) | бюджет 8 × R9700 (4 бита) | оптимум 8 × RTX PRO 6000 или 4 × H200 NVL (FP8) | 330–405 ГБ в FP8 — нужен сервер на 8 карт по 96 ГБ или 4 карты по 141 ГБ |
| GigaChat 3.5 Ultra (Сбер) | 432 / 28 млрд, MoE | мин 4 × H200 NVL (FP8, мало пользователей) | бюджет 4 × RTX PRO 6000 (4 бита) | оптимум 8 × RTX PRO 6000 или 8 × H200 NVL | ~440 ГБ в FP8 и 28 млрд активных — нужна и память, и пропускная способность |
| DeepSeek V4 Pro | 1,6 трлн / 49 млрд, MoE | мин 8 × H200 NVL (1128 ГБ) | — | оптимум HGX B200/B300 или кластер | ~865 ГБ весов; в 8 × 96 ГБ не помещается |
4. Скорость ответа: ориентиры по конфигурациям
Скорость генерации одного пользователя (токенов в секунду) прежде всего зависит от того, сколько данных карта читает из памяти на каждый токен. Ориентир считаем так:
k ≈ 0,6 для плотных моделей и 0,3–0,45 для MoE (у них больше накладных расходов на маршрутизацию)
| Модель и формат | Конфигурация | ток/с на поток | Комментарий |
|---|---|---|---|
| GigaChat 3.1 Lightning, FP8 | 1 × RTX 5060 Ti 16 ГБ | 75–110 | Быстрее, чем человек успевает читать |
| gpt-oss-20b, MXFP4 | 1 × RTX 5060 Ti 16 ГБ | 60–90 | Хороший старт для пилота |
| Qwen3.8-27B, 4 бита | 1 × RTX 5090 | 55–70 | Мало места под кеш — до 5–10 пользователей |
| Qwen3.8-27B, FP8 | 1 × RTX PRO 6000 | 35–45 | Комфортно для 30–60 пользователей за счёт пакетной обработки |
| Qwen3.8-27B, FP8 | 1 × H200 NVL | 80–100 | Память 4,8 ТБ/с — в 2,7 раза быстрее генерация |
| gpt-oss-120b, MXFP4 | мини-ПК GB10 / Ryzen AI Max+ 395 | 30–45 | 1–5 пользователей, долгие ответы на длинные документы |
| gpt-oss-120b, MXFP4 | 1 × RTX PRO 6000 | 130–200 | Одна из самых быстрых крупных моделей |
| Qwen3.5-122B-A10B, FP8 | 2 × RTX PRO 6000 | 60–90 | — |
| DeepSeek V4 Flash, родной формат | 4 × RTX PRO 6000 | 50–80 | Агенты и длинный контекст |
| DeepSeek V4 Flash, родной формат | 2 × H200 NVL | 80–120 | Максимальная скорость, но мало места под кеш |
| Qwen3.5-397B / GLM-5.3-Flash, FP8 | 8 × RTX PRO 6000 | 40–60 | — |
| GigaChat 3.5 Ultra, FP8 | 8 × H200 NVL | 60–80 | — |
| Крупная MoE, 4 бита | EPYC + 768 ГБ DDR5 + 1 GPU | 10–25 | Только 1–3 пользователя |
Для одной карты — расчёт по формуле выше (±30 %). Для нескольких карт приведены консервативные оценки: при делении модели между GPU скорость одного потока растёт заметно медленнее, чем суммарная пропускная способность, зато сильно растёт число одновременных пользователей. Это ориентиры, а не замеры. Реальная скорость зависит от движка (vLLM, SGLang, TensorRT-LLM, llama.cpp), длины контекста, числа одновременных запросов и версии драйверов. Для КП с жёсткими требованиями проводим замер на стенде или в арендованном сервере.
5. Генерация изображений и видео
У моделей генерации картинок другой профиль нагрузки: они много считают, а ответ — одна картинка за несколько секунд. Важны объём памяти (модель плюс текстовый энкодер) и TFLOPS. Обратите внимание на лицензии: не все популярные модели разрешают коммерческое использование бесплатно.
| Модель | Параметры, лицензия | Память | Минимум | Оптимум |
|---|---|---|---|---|
| FLUX.2 [klein] 4B (Black Forest Labs) | 4 млрд, Apache 2.0 | ~8–13 ГБ | мин RTX 5060 Ti 16 ГБ | оптимум RTX 5090 / RTX PRO 4500 — генерация за доли секунды–секунды |
| Qwen-Image-2512 (Alibaba) | 20 млрд, Apache 2.0 | ~41 ГБ в BF16, ~20 ГБ в FP8 + текстовый энкодер | мин RTX 5090 32 ГБ (FP8) | оптимум RTX PRO 5000 48 ГБ или RTX PRO 6000 (BF16) |
| FLUX.2 [dev] (Black Forest Labs) | 32 млрд, некоммерческая лицензия; для бизнеса нужна платная | ~64 ГБ в BF16, ~32 ГБ в FP8, плюс ~18 ГБ текстовый энкодер | мин RTX 5090 (FP8, энкодер на CPU) или 24 ГБ с 4-битной версией | оптимум RTX PRO 6000 96 ГБ — всё в видеопамяти, BF16 |
| Wan 2.2 TI2V-5B (видео) | 5 млрд, Apache 2.0 | ~24 ГБ для 720p | мин RTX 4090 / RTX 5090 | оптимум RTX PRO 6000 — несколько роликов параллельно |
| Wan 2.2 A14B (видео) | MoE 27 / 14 млрд, Apache 2.0 | ~80 ГБ без выгрузки на одной карте | мин RTX PRO 6000 96 ГБ | оптимум 2–8 × RTX PRO 6000 или H200 NVL — генерация видео ресурсоёмка, ролик считается минутами |
Объёмы памяти — по карточкам моделей и данным разработчиков; для FLUX.2 [dev] — по данным NVIDIA и Black Forest Labs о FP8-версии. Для генерации картинок карты NVIDIA пока заметно удобнее: большинство готовых сборок (ComfyUI, diffusers) оптимизированы под CUDA.
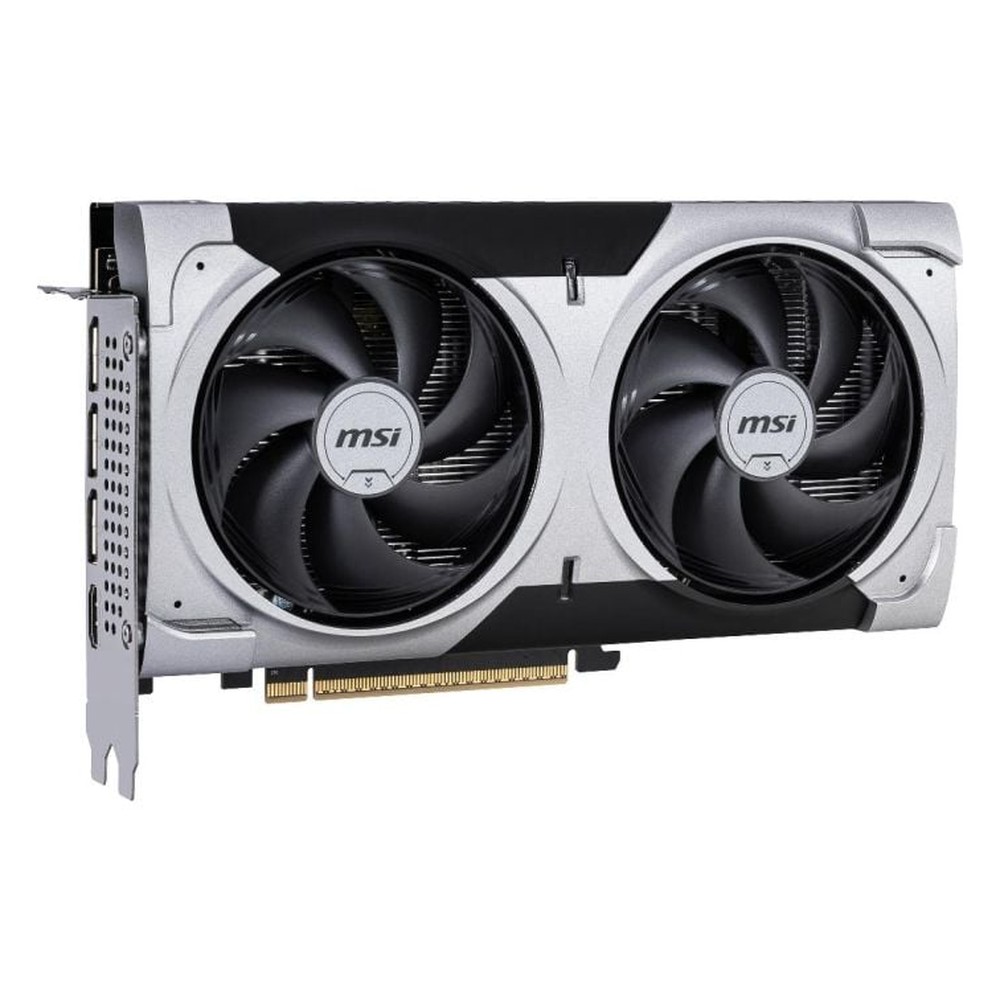 RTX 5060 Ti 16 ГБFLUX.2 klein, SDXL — минимум
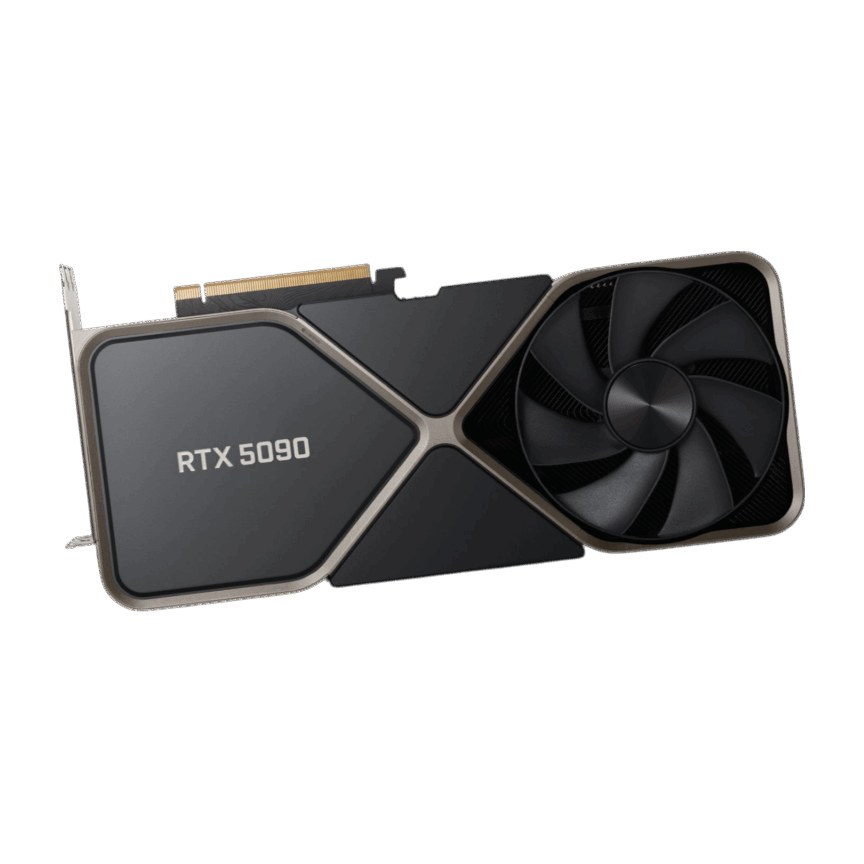 GeForce RTX 5090FLUX.2 dev FP8, Qwen-Image, видео 5B
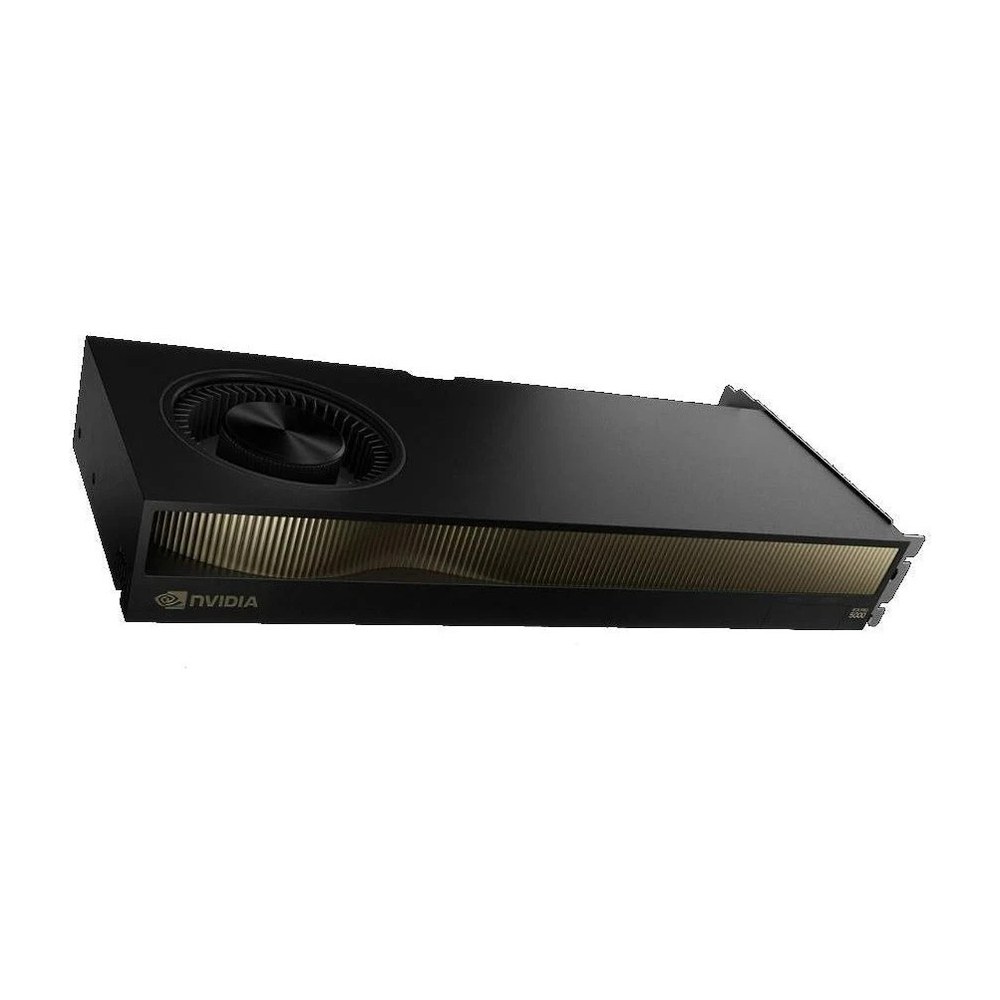 RTX PRO 5000 Blackwell 48 ГБQwen-Image в BF16
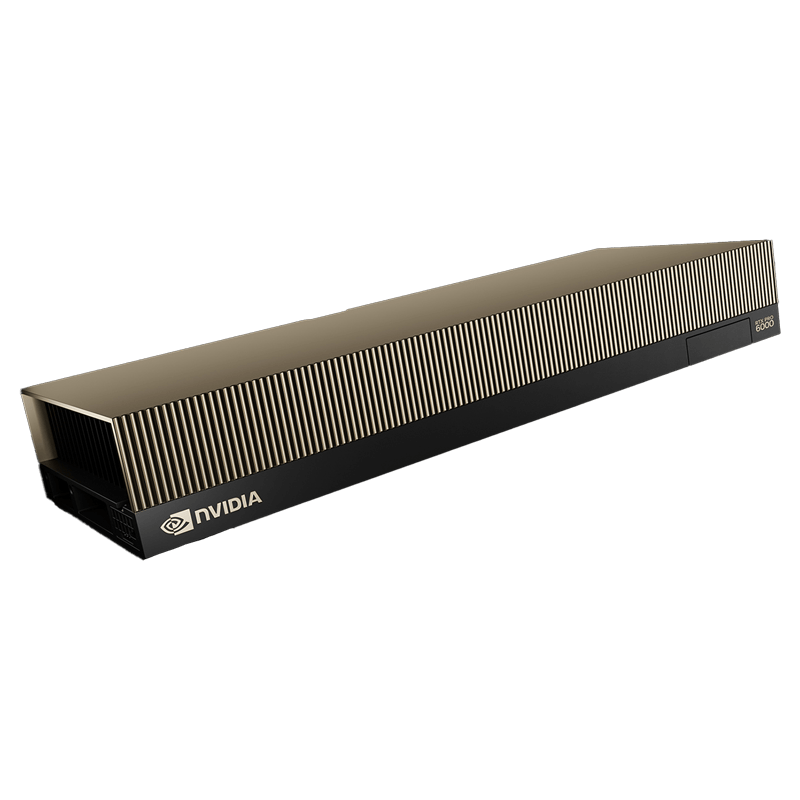 RTX PRO 6000 96 ГБFLUX.2 dev BF16, видео 14B
6. Распознавание речи и поиск по документам
Эти модели маленькие по сравнению с LLM, но часто работают рядом с ними: распознают звонки и совещания, превращают документы в векторы для поиска (RAG). Обычно им не нужен отдельный сервер — достаточно выделить память на той же карте, что и языковая модель.
| Модель | Задача | Параметры, лицензия | Память GPU | Минимум | Оптимум |
|---|---|---|---|---|---|
| GigaAM-v3 (Сбер) | Распознавание русской речи | 220–240 млн, MIT | 1–2 ГБ | мин процессор (ONNX) для офлайн-записей | оптимум NVIDIA L4 или RTX PRO 4000 — десятки потоков одновременно |
| Whisper large-v3 / turbo (OpenAI) | Многоязычное распознавание | 1,55 млрд / 809 млн, MIT | ~6–10 ГБ | мин RTX 5060 Ti 16 ГБ | оптимум L4 / RTX PRO 4000 24 ГБ или общая карта с LLM |
| bge-m3 (BAAI) | Эмбеддинги для поиска, многоязычные | 568 млн, MIT | 2–3 ГБ | мин процессор или любая GPU | оптимум на той же карте, что и LLM |
| Qwen3-Embedding 0.6B / 4B / 8B | Эмбеддинги для поиска | 0,6–8 млрд, Apache 2.0 | 2–18 ГБ | мин 0.6B — на любой GPU | оптимум 8B на отдельной карте 24–32 ГБ для больших баз |
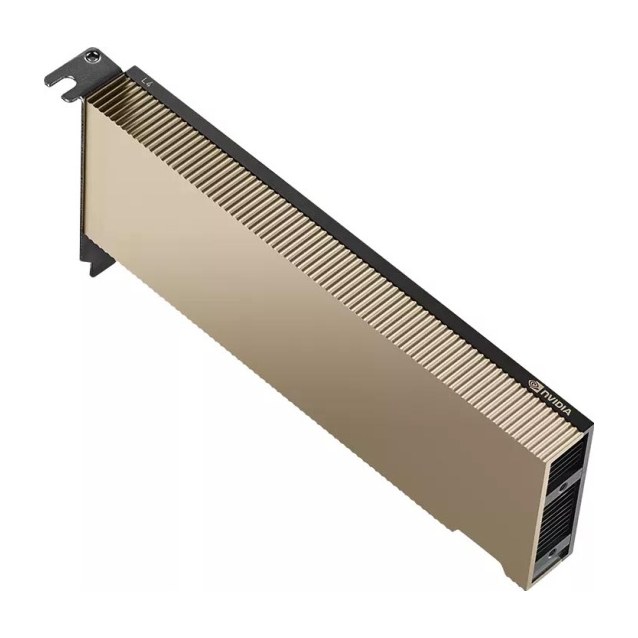 NVIDIA L4 24 ГБречь, эмбеддинги, видеоаналитика · 72 Вт
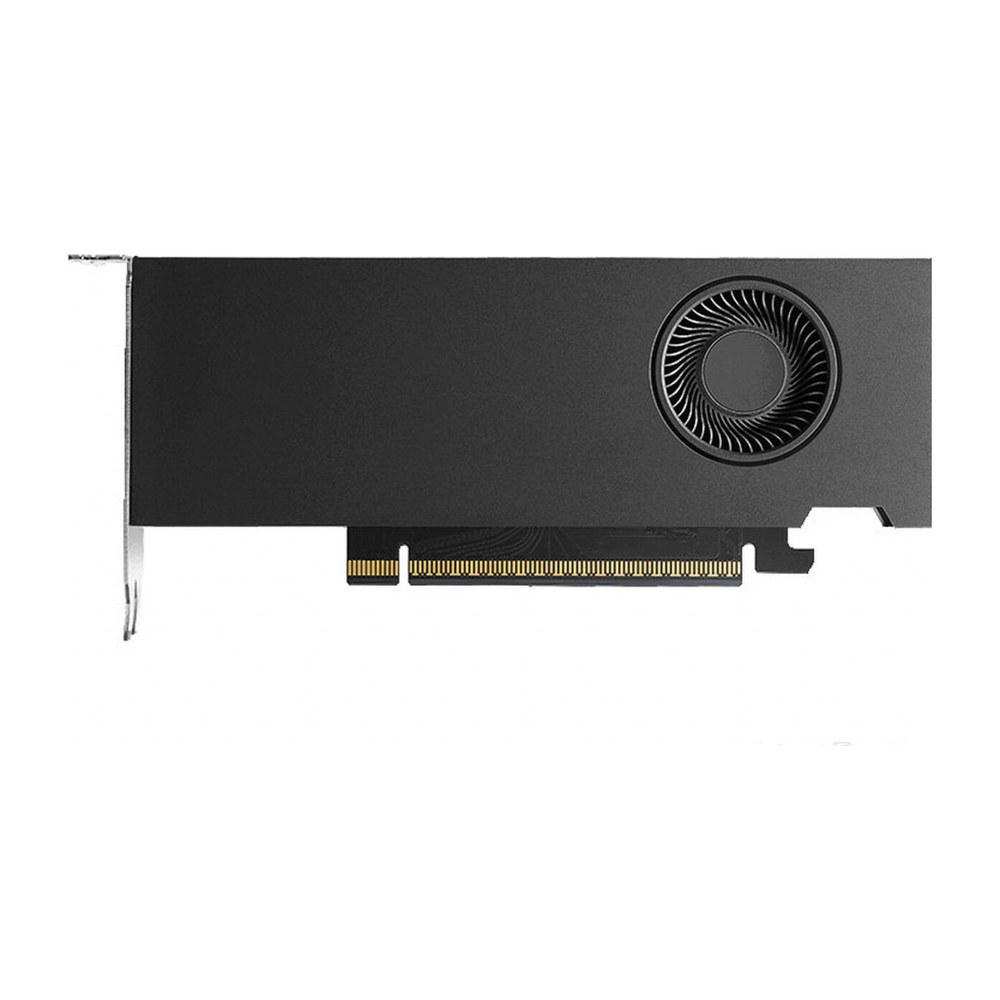 RTX PRO 4000 Blackwell 24 ГБоднослотовая карта для сервисов RAG
7. Компьютерное зрение
Детекция объектов, контроль качества, подсчёт людей и транспорта. Здесь модели совсем маленькие, а нагрузка определяется числом камер и кадров в секунду. Самое популярное семейство детекторов — Ultralytics YOLO, последняя версия YOLO26 вышла в январе 2026 года.
| Модель | Точность mAP 50–95 (COCO) | Параметры, млн | GFLOP на кадр | Время на NVIDIA T4, мс |
|---|---|---|---|---|
| YOLO26n | 40,9 | 2,4 | 5,4 | 1,7 |
| YOLO26s | 48,6 | 9,5 | 20,7 | 2,5 |
| YOLO26m | 53,1 | 20,4 | 68,2 | 4,7 |
| YOLO26l | 55,0 | 24,8 | 86,4 | 6,2 |
| YOLO26x | 57,5 | 55,7 | 193,9 | 11,8 |
Данные Ultralytics для изображений 640 пикселей, TensorRT FP16 на NVIDIA T4. Лицензия Ultralytics — AGPL-3.0; для закрытых коммерческих продуктов нужна корпоративная лицензия Ultralytics.
÷ 0,3–0,4 (реальная загрузка) = 55–75 TFLOPS FP16 → одна серверная карта класса L4 / L40S
или 4–8 камер на каждый Jetson Orin NX прямо на объекте
| Сценарий | Минимум | Оптимум | Почему |
|---|---|---|---|
| 1–4 камеры на линии, контроль качества | мин Hailo-8 / Jetson Orin Nano | оптимум Jetson Orin NX 16 ГБ | Обработка на месте без передачи видео в ЦОД |
| 8–32 камеры, склад или цех | мин Jetson AGX Orin 64 ГБ | оптимум сервер с 1 × L4 / RTX PRO 4000 | Декодирование видео и детекция на одной машине |
| 50–300 камер, город или крупный объект | мин сервер с 1–2 × L40S | оптимум сервер с 4–8 × L40S или RTX PRO 6000 | Нужны аппаратные декодеры и запас под сложные модели |
| Камеры + анализ «по смыслу» (VLM) | мин Jetson AGX Thor 128 ГБ | оптимум сервер с RTX PRO 6000 | Мультимодальная модель описывает сцену и отвечает на вопросы по видео |
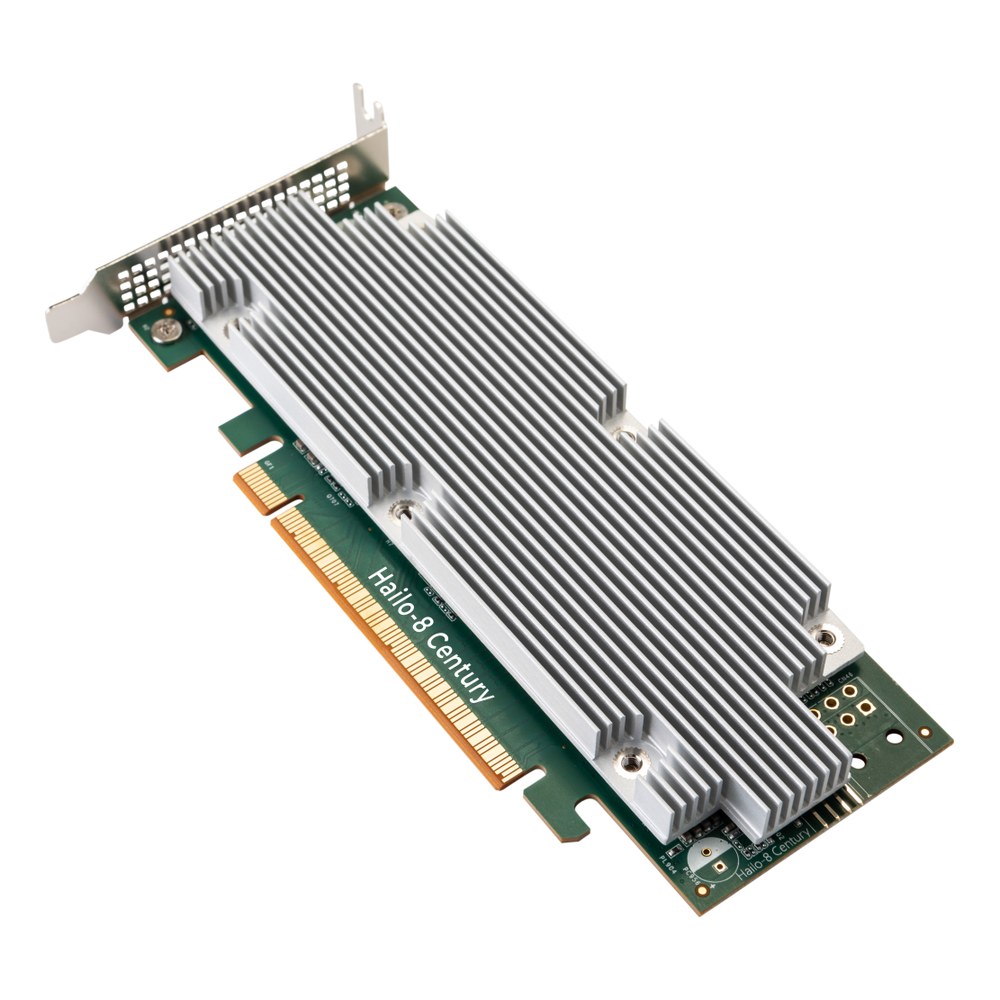 Hailo-8 Century PCIe104 TOPS для видеоаналитики
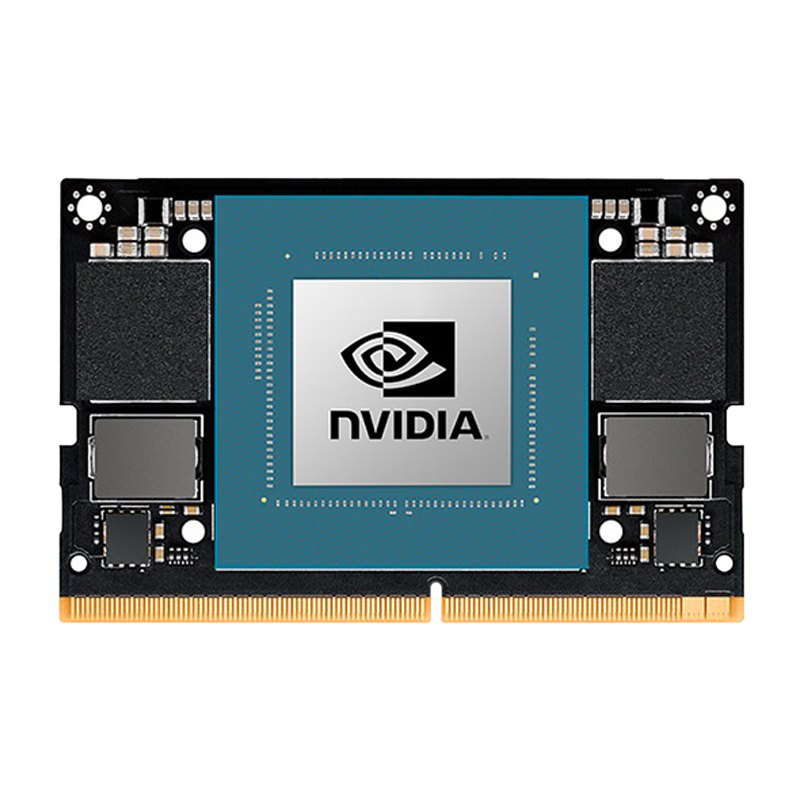 Jetson Orin NX 16 ГБдо 157 TOPS
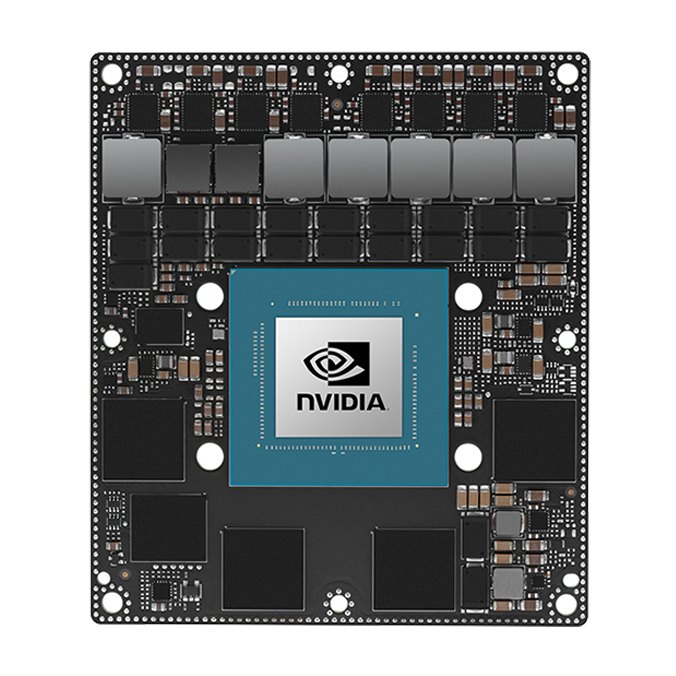 Jetson AGX Orin 64 ГБ275 TOPS
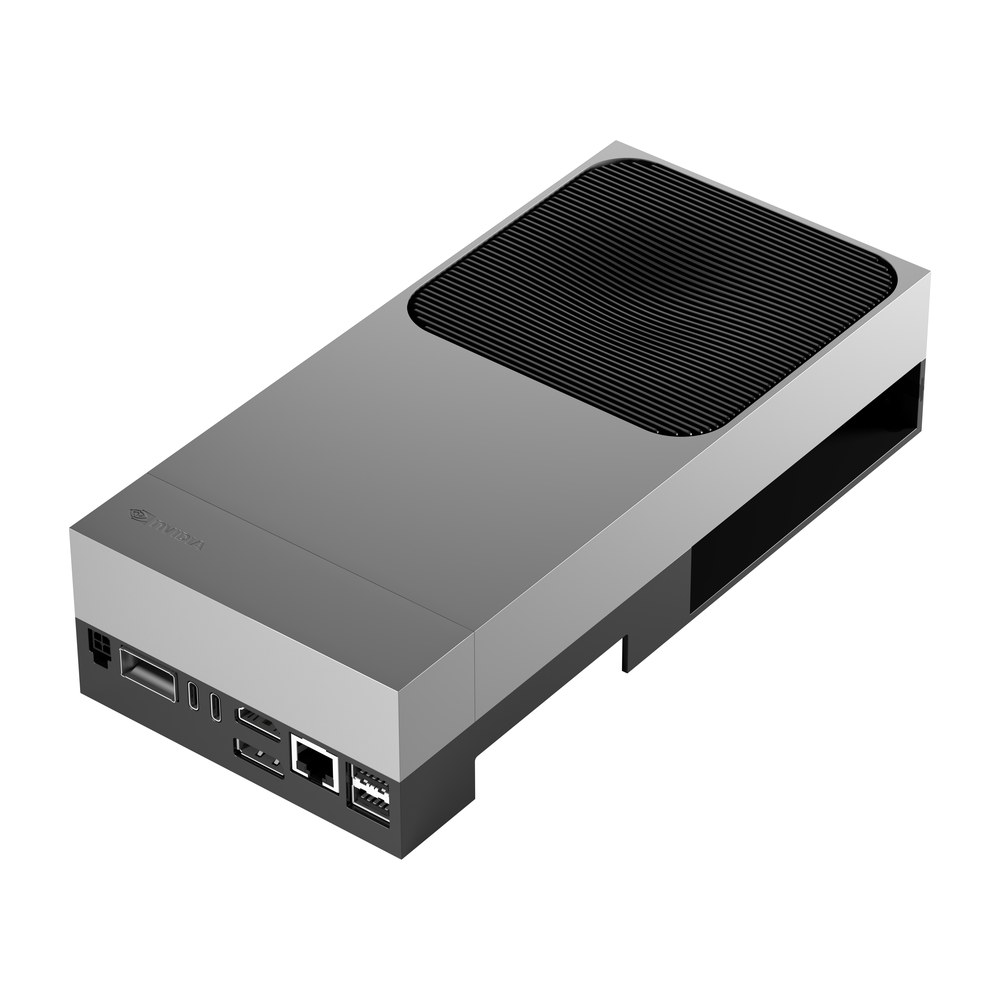 Jetson AGX Thor2070 TFLOPS FP4, 128 ГБ
8. Подбор по задаче: шпаргалка для менеджера
| Задача клиента | Какую модель предложить | Минимальное железо | Оптимальное железо |
|---|---|---|---|
| Пилот «попробовать нейросеть» на 1–5 человек | gpt-oss-120b, Qwen3.8-27B | Мини-ПК 128 ГБ или 1 × RTX 5090 | Рабочая станция с RTX PRO 6000 |
| Корпоративный чат на 50–300 сотрудников | Qwen3.8-27B, T-Pro 2.1, GigaChat 3.1 Lightning | 1 × RTX PRO 6000 | Сервер с 2 × RTX PRO 6000 |
| Поиск по документам (RAG) на 500–1000 сотрудников | gpt-oss-120b, Qwen3.5-122B + bge-m3 / Qwen3-Embedding | 1 × RTX PRO 6000 | 2 × RTX PRO 6000 или 1–2 × H200 NVL |
| ИИ-агенты, помощник программиста | DeepSeek V4 Flash, Qwen3.5-397B | 4 × RTX PRO 6000 | 8 × RTX PRO 6000 или 4 × H200 NVL |
| Флагманская модель для всей компании | GigaChat 3.5 Ultra, GLM-5.3-Flash | 4 × H200 NVL | 8 × H200 NVL или 8 × RTX PRO 6000 |
| Распознавание звонков и совещаний | GigaAM-v3, Whisper | Любая GPU 16 ГБ | L4 / RTX PRO 4000 или общий сервер с LLM |
| Генерация изображений для маркетинга | Qwen-Image-2512, FLUX.2 | 1 × RTX 5090 | RTX PRO 6000 |
| Видеоаналитика | YOLO26, мультимодальные LLM | Jetson Orin NX / AGX Orin | Сервер с L4 / L40S |
Поможем выбрать модель, рассчитаем память и скорость, предложим 2–3 конфигурации — от бюджетной до оптимальной — и развернём модель под ключ.
Нейросеть под ключАренда GPU