

КП на GPU-сервер для инференса LLM: разбор запроса клиента
Пошаговый разбор реального запроса на GPU-серверы: противоречия в ТЗ, выбор платформы, раскладка памяти по каналам, схема PCIe, расчёт питания, дооснащение, гарантия и шаблон ответа клиенту.
Разбираем реальный запрос клиента на GPU-серверы для локального инференса языковой модели: что в требованиях сформулировано точно, где скрыты подводные камни, какую платформу выбрать, как посчитать питание и как оформить ответ на каждый вопрос заказчика. Статья написана как пошаговая инструкция для менеджеров, которые готовят коммерческие предложения на GPU-серверы.
- Запрос клиента
- Разбор требований: что верно, что уточнить, что невозможно
- Выбор платформы
- Базовая конфигурация для всех вариантов
- Варианты по GPU: что получает клиент
- Схема подключения PCIe: пары GPU под одним процессором
- Питание: потребление с 4 и 8 картами
- Дооснащение +2 и +4 карты и гарантия
- Шаблон ответа клиенту
- Чек-лист менеджера для похожих запросов
1. Запрос клиента
Руководитель IT-отдела просит КП на GPU-серверы для локального инференса языковой модели. Модель и производитель платформы — на наш выбор. Ключевые требования:
Клиент просит указать: модель платформы и материнской платы, процессоры и раскладку памяти по каналам; цену, срок и наличие; гарантию на сервер и GPU, в том числе при последующем добавлении карт; схему подключения слотов PCIe; число и мощность блоков питания, схему резервирования и максимальное потребление с 4 и 8 картами.
2. Разбор требований: что верно, что уточнить, что невозможно
| Требование | Оценка | Что предлагаем и почему |
|---|---|---|
| 4U, 8 × PCIe 5.0 x16, двухслотовые пассивные GPU | корректно | Стандартный класс платформ: GIGABYTE G494, ASUS ESC8000, Supermicro AS-4125GS. Важно: платформа должна официально поддерживать 8 карт по 600 Вт, иначе варианты с RTX PRO 6000 Server Edition и H200 NVL на 8 карт не собрать |
| RTX PRO 6000 Max-Q в корпусе «под пассивные карты» | уточнить | Max-Q — рабочая версия с турбиной (300 Вт), а не пассивная. В серверах она работает: выдувает воздух назад, Supermicro указывает её в списке совместимости AS-4125GS-TNRT. Но в MGX-платформах ASUS и GIGABYTE сертифицирована Server Edition. Предлагаем Max-Q на платформе, где она есть в списке совместимости, либо Server Edition |
| 2 процессора, 24–32 ядра, высокая частота | корректно | Для инференса много ядер не нужно, а частота ускоряет токенизацию и планировщик запросов. Оптимально AMD EPYC 9375F (32 ядра, до 4,8 ГГц) или более доступный EPYC 9355 (32 ядра, до 4,4 ГГц) |
| DDR5 от 512 ГБ, все каналы заняты одинаково | уточнить | У EPYC 9005 по 12 каналов на процессор — 24 канала. Ровно 512 ГБ одинаковыми модулями их не заполнить: 24 × 16 ГБ = 384 ГБ (меньше ТЗ), 24 × 24 ГБ = 576 ГБ, 24 × 32 ГБ = 768 ГБ. Предлагаем два варианта: 576 ГБ на модулях 24 ГБ (экономнее, проверяем наличие модулей и QVL платформы) и 768 ГБ — правильнее для сервера с 384–1128 ГБ видеопамяти. Ровно 512 ГБ получается на Intel Xeon 6 (8 каналов × 2 × 32 ГБ). Важно для бюджета: в 2026 году 1 ГБ серверной DDR5 стоит ~2–3,5 тыс. ₽, поэтому разница между 576 и 768 ГБ — около 0,4–0,7 млн ₽ |
| 2 × 1,92 ТБ SATA SSD под данные | рекомендуем улучшить | SATA подходит, но модель на 400 ГБ загружается с него 15+ минут, с NVMe — 1–2 минуты. Предлагаем основной вариант по ТЗ и опцию с NVMe. Проверяем, что корзина платформы поддерживает SATA: у части MGX-платформ отсеки только NVMe |
| 2 × 1 GbE + отдельный BMC | корректно | Для чат-сервиса достаточно. Рекомендуем в опции 2 × 10/25 GbE: быстрее скачивать модели и есть задел для второго сервера |
| БП с резервированием под 8 GPU | корректно, важно | 8 × 600 Вт — это до ~6,3 кВт на сервер. Нужны 4 × 3000–3200 Вт Titanium по схеме 3+1. Расчёт — в разделе 7 |
| Вариант 4: L40S | предупредить | Поколение Ada (2022), 48 ГБ, без FP4, пропускная способность 864 ГБ/с. 8 × L40S (384 ГБ) примерно на четверть дешевле, чем 4 × RTX PRO 6000 (384 ГБ), но занимают все слоты и не оставляют места для роста. Даём цену и рекомендацию |
| Вариант 5: H20 (2, 4, 8 шт.) | невозможно в такой платформе | H20 выпускается только в виде модулей SXM на плате HGX на 8 GPU, PCIe-версии нет. Поэтому ни 2, ни 4 карты в 4U-сервер с PCIe-слотами не установить. 8 × H20 — это отдельный HGX-сервер другого класса. Это китайская экспортная модель: BF16 — 148 TFLOPS, в 5,6 раза меньше, чем у H200 NVL. В Россию она попадает только через параллельный импорт без гарантии производителя. Предлагаем замену — H200 NVL (та же память 141 ГБ, PCIe) или, если клиент готов к экосистеме AMD, Instinct MI350P (144 ГБ HBM3E, 4 ТБ/с, PCIe, пассивная, 450–600 Вт; поставка под заказ) |
| Вариант 6: H200 NVL 2 и 4 шт. | корректно | Предлагаем с NVLink-мостами: для 2 карт — двухпутевой, для 4 — четырёхпутевой (900 ГБ/с на GPU вместо 128 ГБ/с по PCIe). При расширении с 2 до 4 карт мост меняется |
3. Выбор платформы
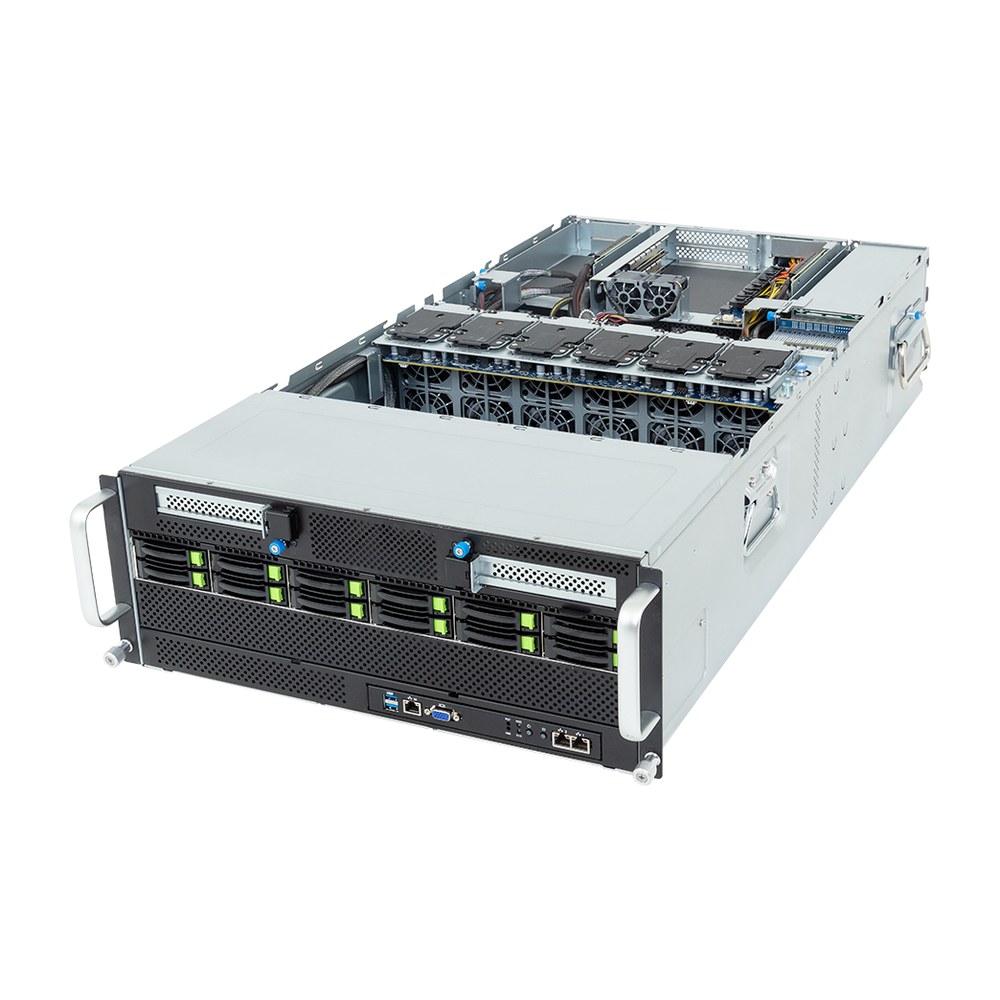 GIGABYTE G494-ZB4-AAP2Основной вариант
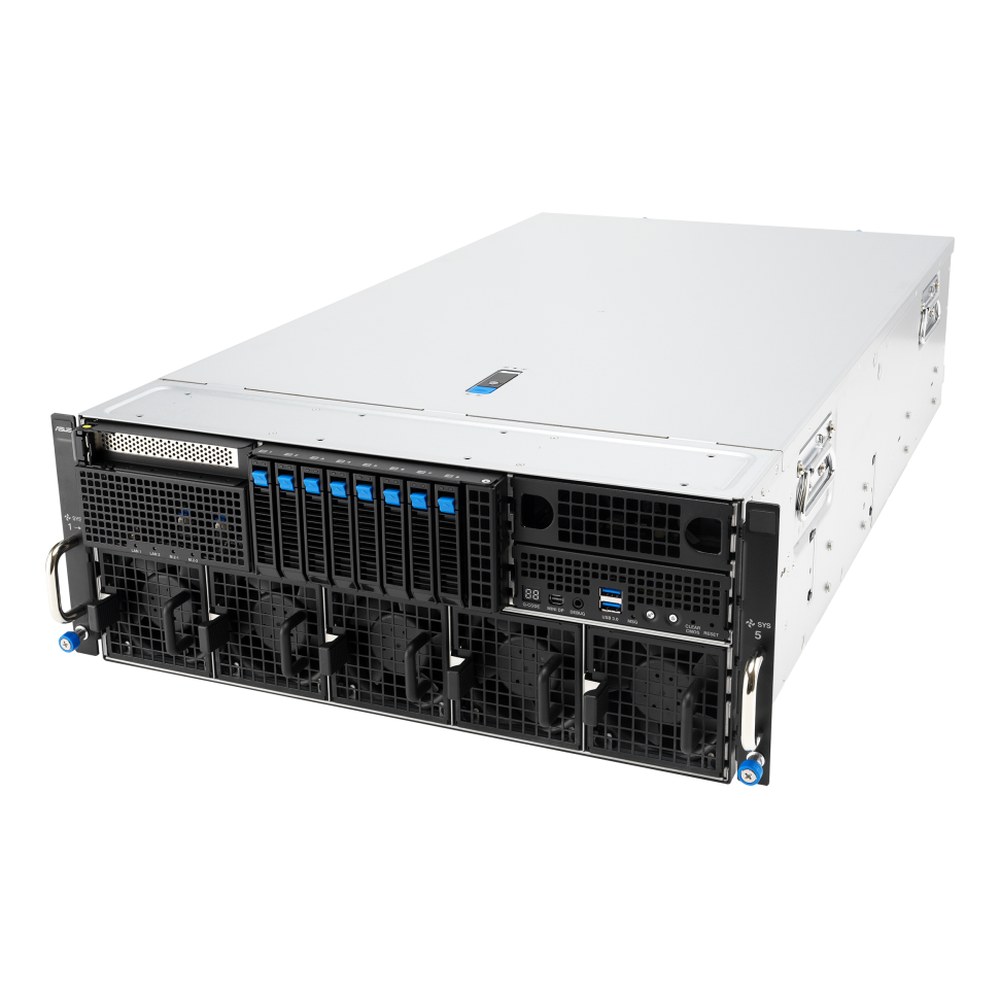 ASUS ESC8000A-E13PАльтернатива на AMD
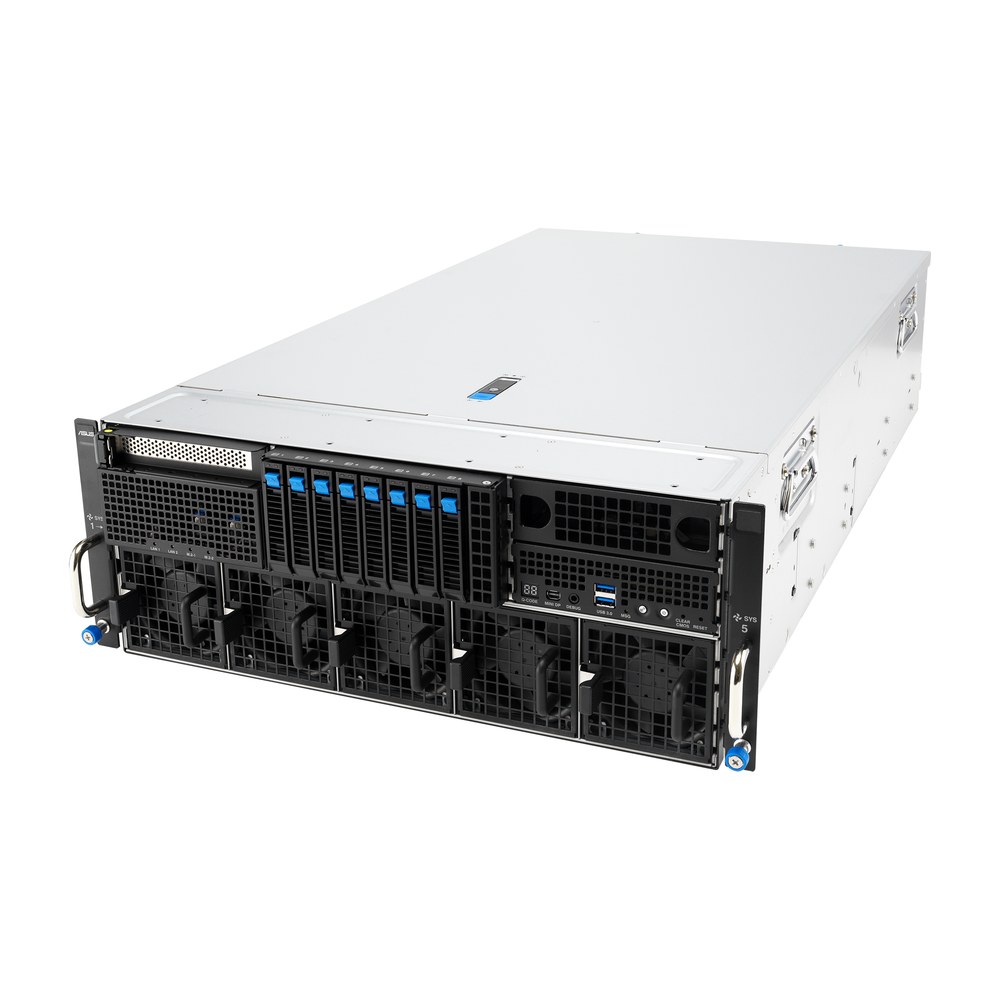 ASUS ESC8000-E12PВариант на Intel Xeon 6
| Параметр | GIGABYTE G494-ZB4-AAP2 | ASUS ESC8000A-E13P | ASUS ESC8000-E12P | Supermicro AS-4125GS-TNRT |
|---|---|---|---|---|
| Процессоры | 2 × AMD EPYC 9004/9005 | 2 × AMD EPYC 9005 | 2 × Intel Xeon 6 (6700/6500) | 2 × AMD EPYC 9004/9005 |
| Память | 48 DIMM, 12 каналов на CPU | 24 DIMM, 12 каналов на CPU | 32 DIMM, 8 каналов на CPU | 24 DIMM, 12 каналов на CPU |
| GPU | 8 × двухслотовых PCIe 5.0, до 8 × 600 Вт (с вентиляторным комплектом), 8 × H200 NVL двумя группами по 4 с NVLink | 8 × двухслотовых, H200 NVL и RTX PRO 6000 Server Edition | 8 × двухслотовых, H200 NVL и RTX PRO 6000 Server Edition | 8 × двухслотовых, в списке совместимости — RTX PRO 6000 Max-Q, L40S |
| Подключение GPU | 2 PCIe-коммутатора Broadcom PEX89144, по 4 GPU на каждом | Через PCIe-коммутаторы Broadcom PEX89000 | Через PCIe-коммутаторы Broadcom | Напрямую к процессорам |
| Питание | 4 × 3000 Вт Titanium | 4 × 3200 Вт Titanium, 3+1 | 4 × 3200 Вт Titanium, 3+1 | 4 × 2000 Вт Titanium (3+1 — до 6 кВт); в текущих поставках — блоки 2700 Вт |
| Сеть | 2 × 1 GbE + BMC | 2 × 10 GbE + BMC | 2 × 10 GbE + BMC | 2 × 10 GbE + BMC |
| Накопители | 12 × 2,5" NVMe/SATA/SAS + 2 × M.2 | 8 × 2,5" NVMe + 2 × M.2 Gen5 | 8 × 2,5" NVMe + 2 × M.2 Gen5 | SATA + NVMe + M.2 |
| Вывод | точнее всего под ТЗ | альтернатива | если нужен Intel | только для карт до 350 Вт |
По спецификациям производителей на ноябрь 2026 года. Перед отправкой КП сверяйте список совместимых GPU (QVL) для конкретной ревизии платформы.
4. Базовая конфигурация для всех вариантов
| Компонент | Предложение | Комментарий для клиента |
|---|---|---|
| Платформа | GIGABYTE G494-ZB4-AAP2, 4U, материнская плата MZB3-G41 | 8 × PCIe 5.0 x16 под двухслотовые GPU, охлаждение под пассивные карты, рельсы в комплекте |
| Процессоры | 2 × AMD EPYC 9375F (32 ядра, 3,8/4,8 ГГц, 320 Вт) бюджетнее: 2 × EPYC 9355 (32 ядра, 3,55/4,4 ГГц, 280 Вт) | Высокая частота для обслуживающих процессов инференса; 128 линий PCIe 5.0 на процессор |
| Память | 24 × 32 ГБ DDR5 RDIMM = 768 ГБ, по 1 модулю в каждый из 12 каналов каждого процессора экономичнее: 24 × 24 ГБ = 576 ГБ | Все 24 канала заняты одинаково (1DPC — максимальная частота). Ровно 512 ГБ при 24 каналах одинаковыми модулями не собрать. Память — заметная часть цены: 768 ГБ DDR5 в 2026 году — 1,5–2,7 млн ₽ |
| Накопители ОС | 2 × M.2 NVMe 960 ГБ, программный RAID1 | По одному M.2 от каждого процессора |
| Накопители данных | 2 × 1,92 ТБ SATA SSD enterprise RI, RAID1 опция: 2 × 3,84 ТБ NVMe RI | Опция с NVMe сокращает загрузку модели с 15+ до 1–2 минут |
| Сеть | 2 × 1 GbE (Intel I350) + выделенный порт BMC опция: адаптер 2 × 25 GbE | Соответствует ТЗ |
| Питание | 4 × 3000 Вт 80 PLUS Titanium, 220–240 В, кабели C19 | Рассчитано на 8 GPU по 600 Вт (раздел 7) |
5. Варианты по GPU: что получает клиент
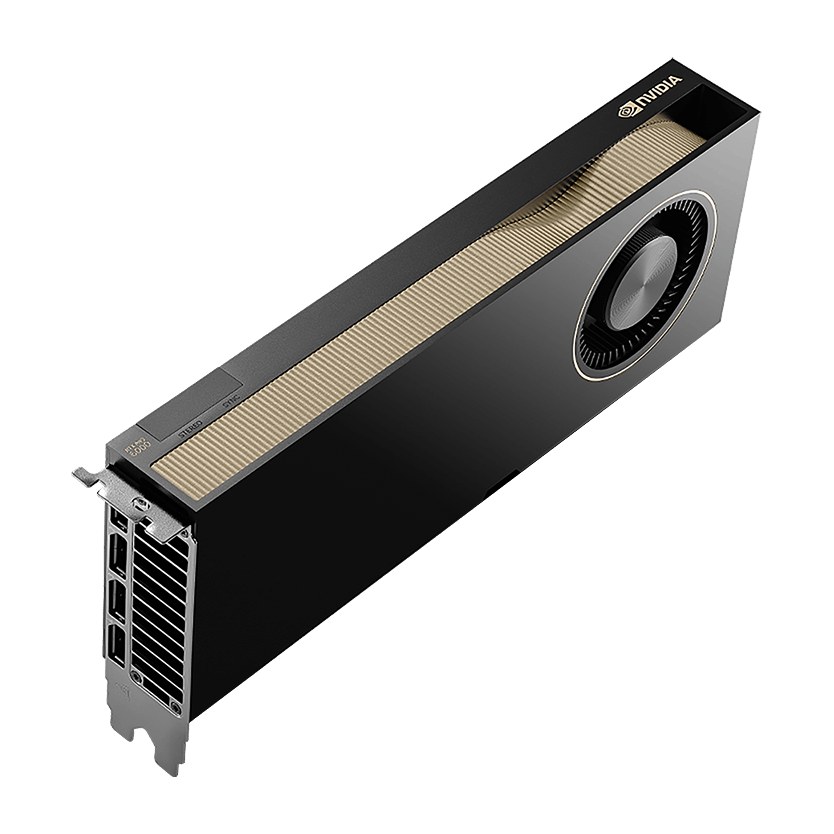 RTX PRO 6000 Max-Q96 ГБ · 300 Вт · турбина
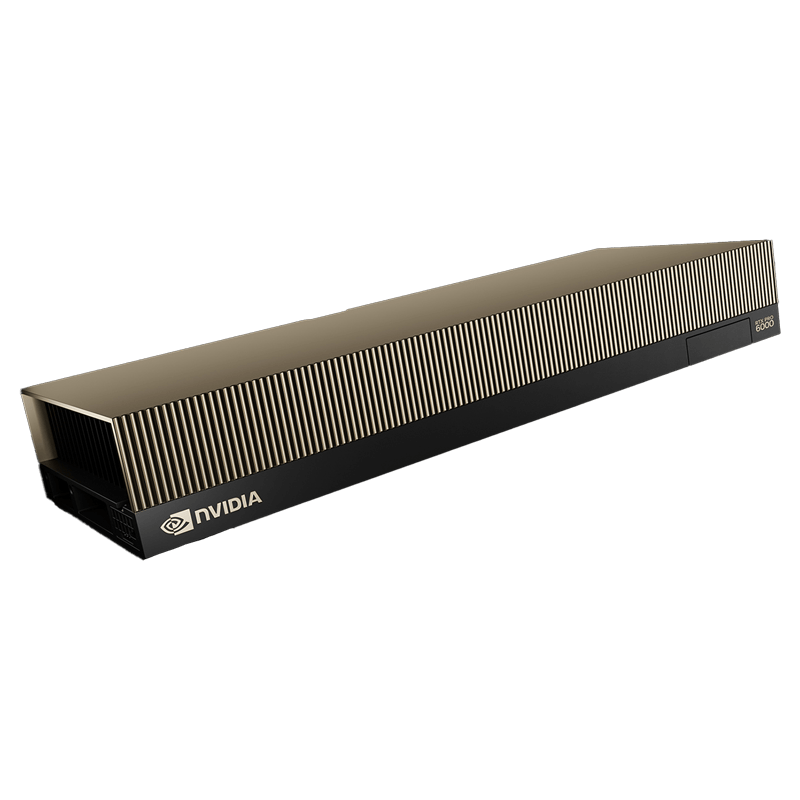 RTX PRO 6000 Server Edition96 ГБ · 600 Вт · пассивная
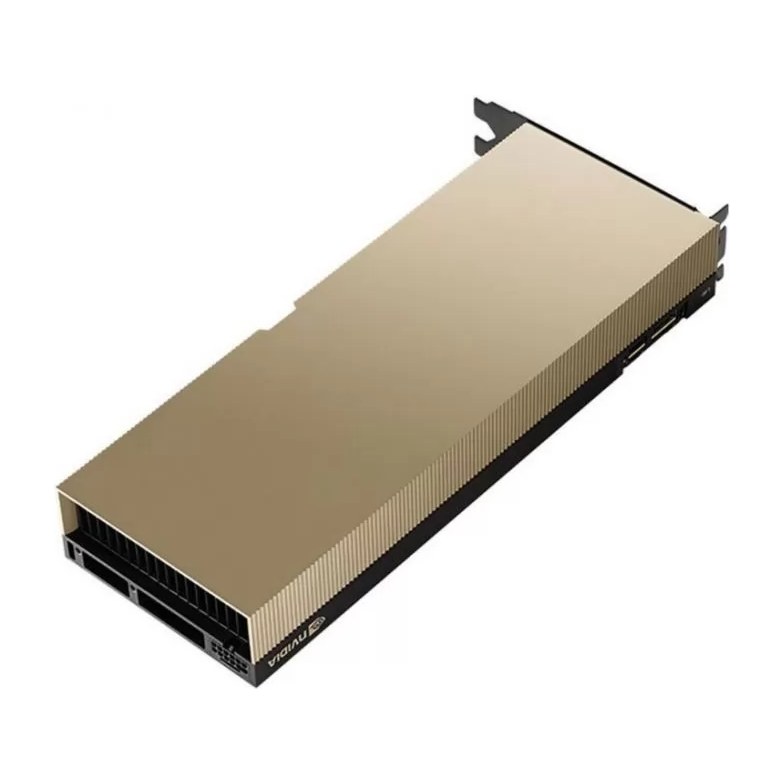 NVIDIA L40S48 ГБ · 350 Вт · пассивная
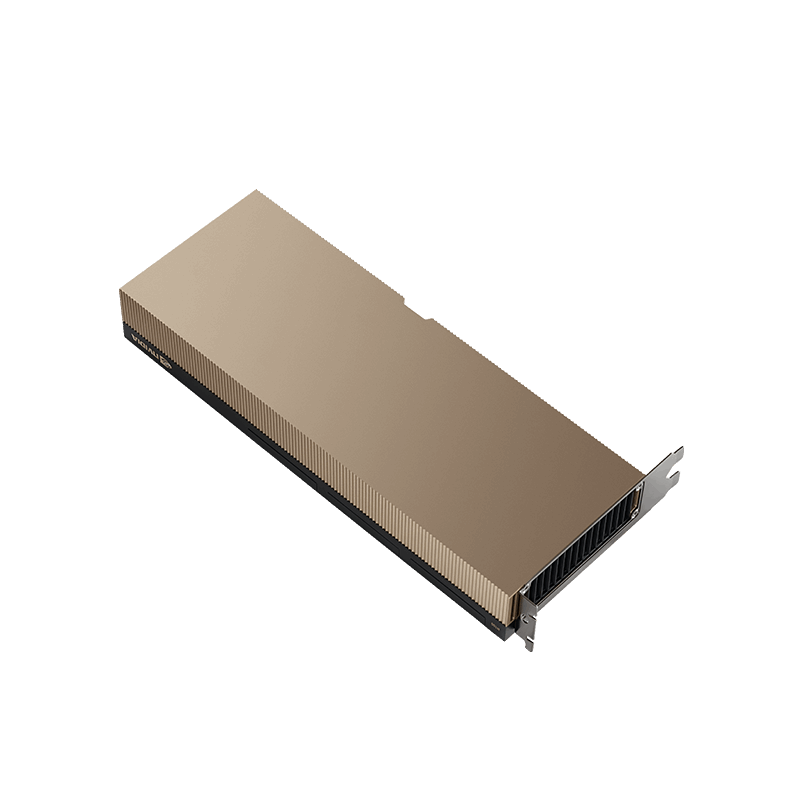 NVIDIA H200 NVL141 ГБ · 600 Вт · NVLink
| Вариант | Память GPU | FP8, PFLOPS | ГБ/с на карту | Какие модели комфортно (FP8, 20–50 пользователей) | Ориентир за карты, ₽ |
|---|---|---|---|---|---|
| 1. 2 × RTX PRO 6000 Max-Q | 192 ГБ | ~1,8 | 1792 | Qwen3.8-27B, Gemma 4 31B в BF16; gpt-oss-120b; Qwen3.5-122B-A10B | ~4,4 млн |
| 2. 4 × RTX PRO 6000 Max-Q | 384 ГБ | ~3,5 | 1792 | + DeepSeek V4 Flash; GLM-5.3-Flash и Qwen3.5-397B — в 4 битах | ~8,8 млн |
| 3. 4 × RTX PRO 6000 Server Edition | 384 ГБ | ~4,0 | 1597 | То же, что вариант 2, плюс ~14 % вычислений, пассивное охлаждение, сертификация в серверных платформах | ~10,8 млн |
| 4а. 4 × L40S | 192 ГБ | ~2,9 | 864 | Qwen3.8-27B, gpt-oss-120b; генерация примерно вдвое медленнее, чем на RTX PRO 6000 | ~4,3 млн |
| 4б. 8 × L40S | 384 ГБ | ~5,9 | 864 | DeepSeek V4 Flash; без FP4; все слоты заняты — расти некуда | ~8,6 млн |
| 5. H20 | не поставляется в PCIe-исполнении — предлагаем заменить на вариант 6 или отдельный HGX-сервер на 8 × H20 по запросу | ||||
| 5*. 2 / 4 × AMD Instinct MI350P | 288 / 576 ГБ | ~4,6 / 9,2 | 4000 | Альтернатива H200 NVL на AMD: больше FP8, память 144 ГБ на карту; совместимость с платформой и работу моделей на ROCm проверяем до КП | по запросу |
| 6а. 2 × H200 NVL + NVLink | 282 ГБ | ~3,3 | 4800 | DeepSeek V4 Flash; самая быстрая генерация на крупных моделях | ~10 млн |
| 6б. 4 × H200 NVL + NVLink | 564 ГБ | ~6,7 | 4800 | GigaChat 3.5 Ultra, Qwen3.5-397B, GLM-5.3-Flash в FP8; дообучение моделей до ~70 млрд параметров | ~20 млн |
Ориентиры — середина диапазона открытых прайсов РФ на ноябрь 2026 года, без платформы, монтажа и НДС. Разброс цен на H200 NVL в РФ большой — от 4 до 6+ млн ₽ за карту, поэтому 8 × H200 NVL — это 32–50 млн ₽ только за карты. Цена в КП — только по актуальному предложению поставщика. RTX PRO 6000 Max-Q заметно дешевле Server Edition (1,8–2,6 млн ₽ против 2,5–2,9 млн ₽) — это ещё один аргумент за варианты 1–2, если платформа официально поддерживает Max-Q.
6. Схема подключения PCIe: пары GPU под одним процессором
Клиенту важно, чтобы пары GPU, которые совместно обслуживают модель, были подключены к одному процессору: обмен между картами тогда не проходит через межпроцессорную шину. В G494-ZB4-AAP2 восемь GPU-слотов разделены на две группы по четыре, каждая за своим коммутатором PCIe 5.0:
- 2 GPU — ставим в одну группу (слоты 1–2): обе карты за одним коммутатором и одним процессором, обмен идёт напрямую через коммутатор (P2P) на скорости PCIe 5.0 x16.
- 4 GPU — заполняем одну группу целиком: все четыре карты за одним коммутатором, для H200 NVL — четырёхпутевой NVLink-мост.
- 8 GPU — две группы по 4; модель разворачивают с тензорным параллелизмом внутри группы и конвейерным между группами.
7. Питание: потребление с 4 и 8 картами
Считаем пиковое потребление: TDP карт плюс платформа (2 процессора по 280–320 Вт, 24 модуля памяти, вентиляторы на максимальных оборотах, накопители и сеть) — 1,1–1,5 кВт.
| Вариант | Вт на карту | Сервер с 4 GPU, кВт | Сервер с 8 GPU, кВт | Запас при 4 × 3000 Вт (3+1 = 9 кВт) |
|---|---|---|---|---|
| RTX PRO 6000 Max-Q | 300 | ~2,4 | ~3,7 | большой |
| L40S | 350 | ~2,6 | ~4,1 | большой |
| RTX PRO 6000 Server Edition | 600 | ~3,7 | ~6,3 | достаточный |
| H200 NVL | до 600 | ~3,7 | ~6,3 | достаточный |
- Схема 3+1: при отказе одного блока три оставшихся (9 кВт при 220–240 В) держат сервер с 8 картами по 600 Вт.
- Два независимых ввода (A/B, схема 2+2): на одном вводе остаётся 6 кВт — меньше пиковых ~6,3 кВт. Для полной защиты от отказа ввода с 8 картами по 600 Вт ограничиваем мощность GPU до 450–500 Вт (H200 NVL официально настраивается от 400 до 600 Вт). Для Max-Q и L40S схема 2+2 работает без ограничений.
- Требования к площадке: 4 розетки C19/C20 на 16 А, 220–240 В; стойка не менее 7–8 кВт под один сервер с 8 картами по 600 Вт; ИБП на эту мощность.
8. Дооснащение +2 и +4 карты и гарантия
| Что входит в цену дооснащения | Комментарий |
|---|---|
| Карты | Только той же модели, что уже установлены: производители сертифицируют платформы для однотипных GPU, смешанные конфигурации не поддерживаются |
| Кабели питания GPU (12V-2x6 / CEM5 16-pin) | В комплекте G494-ZB4 их 8, повторно не покупаются; для других платформ — проверить |
| NVLink-мосты (H200 NVL) | 2 → 4 карты: двухпутевой мост заменяется на четырёхпутевой; 4 → 8: второй четырёхпутевой мост |
| Вентиляторный комплект | Для 8 × H200 NVL в G494-ZB4 нужен дополнительный комплект вентиляторов, а температура в помещении — до 25 °C. Комплект выгоднее поставить сразу |
| Работы | Выезд, установка, обновление BIOS/BMC, нагрузочный тест 24–48 часов, проверка топологии |
| Позиция | +2 карты | +4 карты |
|---|---|---|
| RTX PRO 6000 Max-Q | ~4,4 млн ₽ + работы | ~8,8 млн ₽ + работы |
| RTX PRO 6000 Server Edition | ~5,4 млн ₽ + работы | ~10,8 млн ₽ + работы |
| L40S | ~2,2 млн ₽ + работы | ~4,3 млн ₽ + работы |
| H200 NVL | ~10 млн ₽ + мост + работы | ~20 млн ₽ + мост + работы |
Ориентиры для понимания порядка сумм; в КП — цены поставщика на дату предложения.
Как отвечать про гарантию
- Сервер: срок и формат (ремонт или замена компонентов, реакция «следующий рабочий день», выезд инженера — включён или опция) — по условиям поставщика платформы. Указываем отдельной строкой.
- GPU: отдельный срок — у ускорителей он часто отличается от гарантии на платформу. Указываем формат (замена или ремонт), срок обмена и есть ли подменный фонд.
- Добавление карт: гарантия на сервер сохраняется, если устанавливаются карты из списка совместимости платформы той же модели, установку выполняет поставщик или она проводится по согласованной процедуре. На новые карты действует их собственный гарантийный срок с даты поставки.
- Расширенная гарантия: предлагаем опцию продления (например, до 4–5 лет) — для оборудования 24/7 клиенты выбирают её часто.
9. Шаблон ответа клиенту
Добрый день!
Благодарим за запрос. Предлагаем единую платформу для всех вариантов — GIGABYTE G494-ZB4-AAP2 (4U, материнская плата MZB3-G41, 8 × PCIe 5.0 x16 под двухслотовые пассивные GPU, официальная поддержка 8 карт по 600 Вт и 8 × H200 NVL с NVLink-мостами).
1. Платформа, процессоры, память. 2 × AMD EPYC 9375F (32 ядра, до 4,8 ГГц). Память 768 ГБ: 24 × 32 ГБ DDR5 RDIMM, по одному модулю в каждый из 12 каналов каждого процессора; экономичный вариант — 576 ГБ (24 × 24 ГБ). Ровно 512 ГБ одинаковыми модулями на 24 канала не набрать, поэтому предлагаем ближайшие корректные объёмы. ОС: 2 × M.2 NVMe 960 ГБ (RAID1); данные: 2 × 1,92 ТБ SATA SSD RI (RAID1), опционально NVMe; 2 × 1 GbE + BMC; 4 × 3000 Вт Titanium; рельсы.
2. Цены, сроки, наличие — в таблице вариантов [таблица: вариант / состав GPU / цена / срок / наличие]. По варианту 5: NVIDIA H20 выпускается только в виде модулей SXM на плате HGX на 8 GPU и не устанавливается в PCIe-слоты, поэтому варианты 2 и 4 × H20 технически невозможны. Предлагаем заменить их на H200 NVL 141 ГБ (вариант 6), на AMD Instinct MI350P 144 ГБ (PCIe, поставка под заказ) или по запросу рассчитаем отдельный HGX-сервер на 8 × H20.
3. Гарантия. Сервер — [срок, формат, выезд]. GPU — [срок, формат]. При дооснащении картами той же модели из списка совместимости, установленными нашими инженерами, гарантия на сервер сохраняется; на новые карты действует собственный гарантийный срок.
4. Схема PCIe. 8 GPU-слотов разделены на две группы по 4, каждая за своим коммутатором PCIe 5.0 (Broadcom PEX89144). Пары и четвёрки GPU устанавливаются в одну группу. Блок-схему и таблицу соответствия слотов прилагаем.
5. Питание. 4 × 3000 Вт, резервирование 3+1 (9 кВт при отказе одного блока). Пиковое потребление: с 4 картами по 600 Вт — ~3,7 кВт, с 8 картами — ~6,3 кВт; с Max-Q — ~2,4 / 3,7 кВт; с L40S — ~2,6 / 4,1 кВт. При питании от двух независимых вводов (2+2) с 8 картами по 600 Вт рекомендуем ограничить мощность GPU до 450–500 Вт.
Дополнительно можем развернуть на сервере выбранную модель (vLLM, OpenAI-совместимый API, веб-чат с авторизацией через AD) и провести нагрузочное тестирование.
10. Чек-лист менеджера для похожих запросов
- Проверить, существуют ли запрошенные GPU в нужном исполнении: PCIe или SXM (H20, H100/H200 SXM, B200 — только SXM на платах HGX).
- Сверить GPU со списком совместимости платформы, особенно для карт с турбиной (Max-Q) и мощностью 600 Вт.
- Посчитать каналы памяти: EPYC 9004/9005 — 12 на процессор, Xeon 6700/6500 — 8, Xeon 5-го поколения — 8. Объём = каналы × размер модуля; не забывать про модули 24/48/96 ГБ. В 2026 году память — одна из самых дорогих строк спецификации, считаем её отдельно.
- Проверить статус платформы у производителя и дистрибьютора: «анонсирована» и «есть на складе» — разные вещи.
- Посчитать питание: сумма TDP GPU + 1,1–1,5 кВт на платформу; проверить схему 3+1 и 2+2.
- Уточнить у клиента площадку: мощность на стойку, розетки C19, ИБП.
- Приложить блок-схему PCIe и порядок установки карт.
- Для H200 NVL — включить NVLink-мосты и учесть их замену при росте с 2 до 4 карт.
- Разделить гарантию на сервер и GPU; прописать условия дооснащения.
- Предложить улучшения по скорости загрузки (NVMe) и сети (10/25 GbE) отдельными опциями, не меняя базовый вариант по ТЗ.
- Показать, какие модели поместятся в каждый вариант (таблицы из руководства по сборке и обзора «Какое железо нужно популярным нейросетям»), и при необходимости посчитать нагрузку по методике из статьи про FLOPS.
- Если бюджет ограничен — предложить промежуточный вариант из статьи о бюджетных сборках или аренду с правом выкупа.
- Предложить услугу «под ключ»: развёртывание модели, интеграции и поддержку.
Пришлите ТЗ — подготовим КП с выбором платформы, схемой PCIe, расчётом питания и вариантами GPU.
Нейросеть под ключGPU-серверы в каталоге