

Как собрать сервер для нейросети в 2026 году: память, GPU и требования популярных моделей
Из чего состоит сервер для LLM, как посчитать видеопамять и скорость ответа, сравнение GPU и минимальные и оптимальные конфигурации для GigaChat, Qwen, DeepSeek, GLM, gpt-oss и Gemma.
Практическое руководство для тех, кто подбирает сервер под локальную нейросеть: из чего он состоит, какие параметры действительно влияют на результат, сколько памяти и какие видеокарты нужны популярным открытым моделям на ноябрь 2026 года — с минимальными и оптимальными конфигурациями, объяснением «почему так» и вариантами замены.
- Четыре ресурса, от которых зависит работа нейросети
- Как посчитать память: веса, KV-кеш, запас
- От чего зависит скорость ответа
- Из чего состоит сервер для нейросети
- Сравнение видеокарт и ускорителей
- Популярные открытые модели: размеры и требования
- Минимальное и оптимальное железо для каждой модели
- Чем можно заменить и на чём нельзя экономить
- Шпаргалка: 10 вопросов клиенту перед расчётом
1. Четыре ресурса, от которых зависит работа нейросети
Языковая модель (LLM) — это файл с миллиардами чисел (параметров, или «весов»). Чтобы модель отвечала, все веса должны лежать в быстрой памяти видеокарты, а при генерации каждого слова (токена) видеокарта заново прочитывает активную часть весов и выполняет над ними вычисления. Поэтому сервер для нейросети подбирают не по «мощности вообще», а по четырём конкретным параметрам.
Остальное железо — процессор, оперативная память, диски, сеть, блоки питания и охлаждение — не делает нейросеть «умнее», но может стать узким местом: медленная загрузка модели с диска, нехватка линий PCIe, перегрев карт, отключение при пиковой нагрузке.
2. Как посчитать нужную память
Память под модель складывается из трёх частей: веса, KV-кеш (рабочая память под контекст каждого пользователя) и служебный запас.
веса = число параметров × байт на параметр
KV-кеш ≈ (КБ на токен) × длина контекста × число одновременных запросов
Сколько весит один параметр
| Формат весов | Байт на параметр | Модель 30 млрд параметров | Качество | Где используется |
|---|---|---|---|---|
| BF16 / FP16 (исходный) | 2 | ~60 ГБ | эталон | Обучение, дообучение, максимальное качество |
| FP8 | 1 | ~30 ГБ | почти без потерь | Основной формат промышленного инференса на Hopper, Ada, Blackwell |
| INT4 / NVFP4 / MXFP4 / GGUF Q4 | 0,5–0,6 | ~17 ГБ | небольшие потери | Экономия памяти; часть моделей сразу выпускается в 4-битном виде (gpt-oss, DeepSeek V4) |
| 2–3 бита | 0,3–0,4 | ~10 ГБ | заметные потери | Эксперименты, запуск «любой ценой» |
KV-кеш: память под контекст и пользователей
Пока модель читает запрос и пишет ответ, она сохраняет промежуточные данные по каждому токену контекста — это KV-кеш. Его объём растёт линейно с длиной контекста и числом одновременных запросов. Для «классической» модели около 30 млрд параметров это порядка 0,25 МБ на токен в FP16: один диалог с контекстом 32 тыс. токенов — около 8 ГБ, а 20 таких диалогов одновременно — 160 ГБ, больше, чем сами веса.
Новое поколение моделей 2026 года (Qwen3.5/3.8, GigaChat 3.5, GLM-5.3, DeepSeek V4) использует гибридное или сжатое внимание, и KV-кеш у них в 3–10 раз меньше. Например, разработчики GigaChat 3.5 Ultra указывают примерно четырёхкратное сокращение KV-кеша на токен по сравнению с прошлым поколением. Дополнительно кеш можно хранить в FP8 — это ещё вдвое меньше.
3. От чего зависит скорость ответа
Работа модели делится на две фазы, и они упираются в разные ресурсы:
Пример: RTX PRO 6000 (1,8 ТБ/с), Qwen3.8-27B в FP8 (27 ГБ) → ≈ 65 ток/с теоретически, ≈ 35–45 на практике
MoE-модели: «большие, но быстрые»
Большинство крупных моделей 2026 года построены по схеме Mixture-of-Experts (MoE, «смесь экспертов»): параметров сотни миллиардов, но на каждый токен работает лишь небольшая часть — «активные» параметры. Для сервера это означает:
Из этого следует важный вывод: для MoE-моделей выгодно много памяти с умеренной вычислительной мощностью, а для плотных (dense) моделей — быстрые карты с высокой пропускной способностью.
4. Из чего состоит сервер для нейросети
| Компонент | На что влияет | Типично для инференс-сервера (2026) | Почему именно так | Чем можно заменить |
|---|---|---|---|---|
| GPU | Всё: память, скорость, число пользователей | 2–8 × RTX PRO 6000 Blackwell 96 ГБ или H200 NVL 141 ГБ | Максимум памяти на слот, FP8/FP4, серверное исполнение, гарантия | RTX 5090, L40S, Radeon AI PRO R9700 — дешевле, но меньше памяти на карту |
| Процессоры | Линии PCIe, подготовка данных, токенизация, планировщик запросов | 2 × AMD EPYC 9005 (24–32 ядра, высокая частота) или Intel Xeon 6 | Нужно 128+ линий PCIe 5.0 под 8 GPU и сеть; высокая частота ускоряет «обвязку» инференса | 1 процессор — для 2–4 GPU; много ядер не нужно |
| Оперативная память | Загрузка модели, кеши, выгрузка KV-кеша, RAG | 512–1536 ГБ DDR5, все каналы заняты | Правило: ОЗУ ≥ суммарной памяти GPU; все каналы — для полной пропускной способности. Учитывайте цену: в 2026 году 1 ГБ серверной DDR5 стоит ~2–3,5 тыс. ₽, и 768 ГБ — это 1,5–2,7 млн ₽ | Меньше, если модель маленькая и сервер не делит ресурсы; модули 24/48/96 ГБ, чтобы набрать нужный объём при всех занятых каналах |
| Диски | Скорость старта и смены моделей, векторная БД | 2 × NVMe под ОС (RAID1) + NVMe 3,84–7,68 ТБ под модели и данные | Модель 400 ГБ с SATA SSD грузится 15+ минут, с NVMe Gen4/5 — 1–2 минуты | SATA SSD — дешевле, но медленный старт |
| Сеть | Доступ пользователей, скачивание моделей, кластер | 2 × 10/25 GbE; для кластера — 200–400 Гбит/с InfiniBand/Ethernet | Для чата хватает 1–10 GbE; для объединения серверов нужна быстрая сеть с RDMA | Встроенные 1 GbE — только для одиночного сервера |
| Питание | Стабильность под нагрузкой | 4 × 2700–3200 Вт Titanium, резервирование 3+1 | 8 карт по 600 Вт — это 4,8 кВт только на GPU; сервер целиком — до 6,5 кВт | Ограничение мощности карт (power cap) при слабом вводе |
| Корпус и охлаждение | Плотность, шум, надёжность 24/7 | 4U на 8 двухслотовых GPU с продувом спереди назад | Серверные карты пассивные — охлаждает корпус; игровые карты в такой корпус не встают | Рабочая станция (tower) — для 1–4 карт |
| ПО | Скорость и функции | Linux + vLLM / SGLang / TensorRT-LLM; llama.cpp для небольших установок | Промышленные движки дают пакетную обработку, кеш префиксов, OpenAI-совместимый API | Ollama / LM Studio — для пилота на 1–5 пользователей |
5. Сравнение видеокарт и ускорителей (ноябрь 2026)
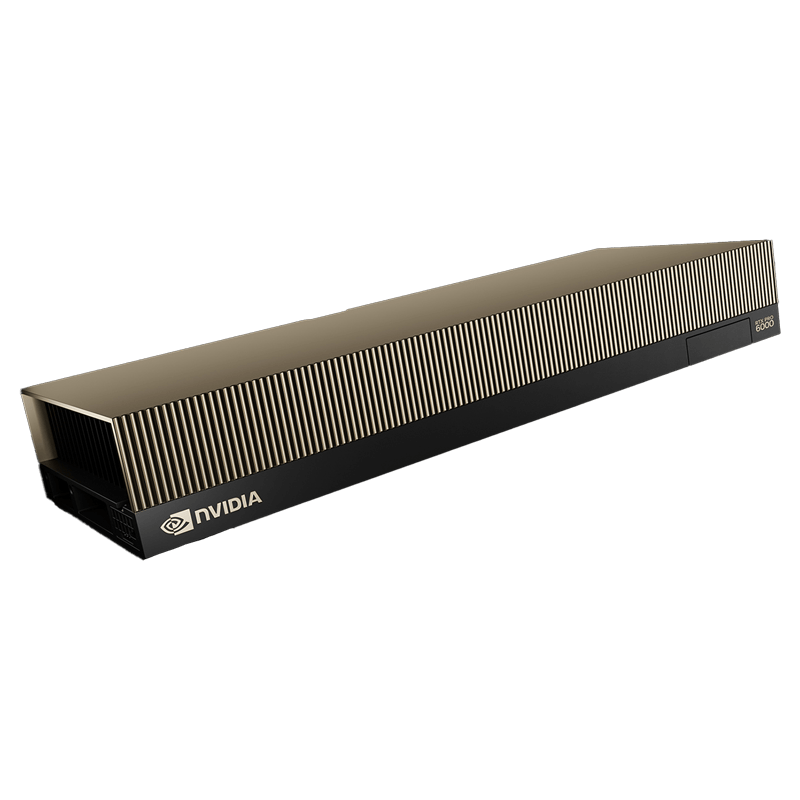 RTX PRO 6000 Blackwell Server Edition96 ГБ · основная карта для инференса
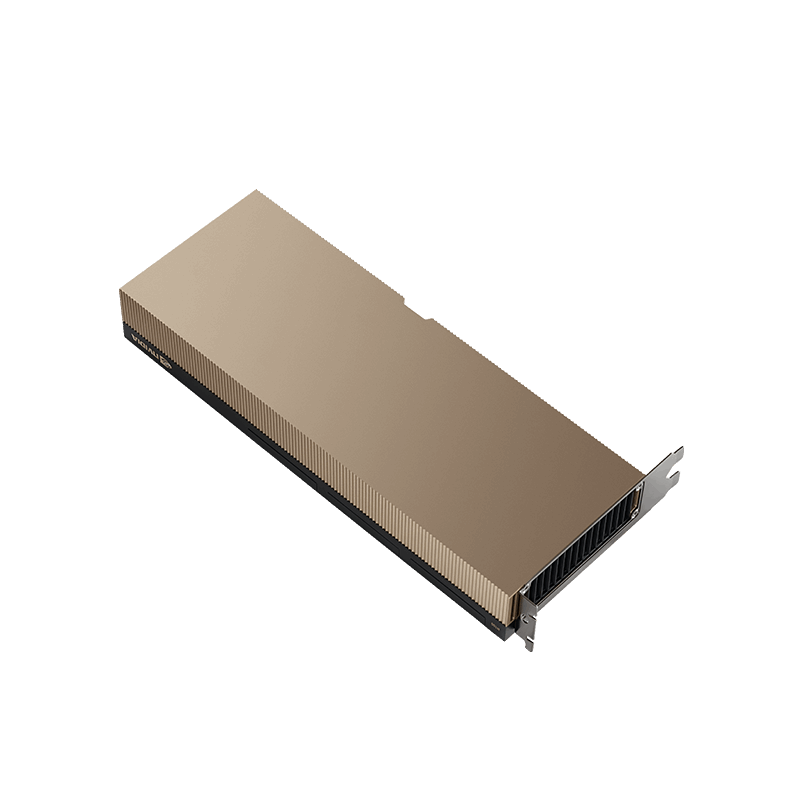 NVIDIA H200 NVL141 ГБ HBM3e · 4,8 ТБ/с
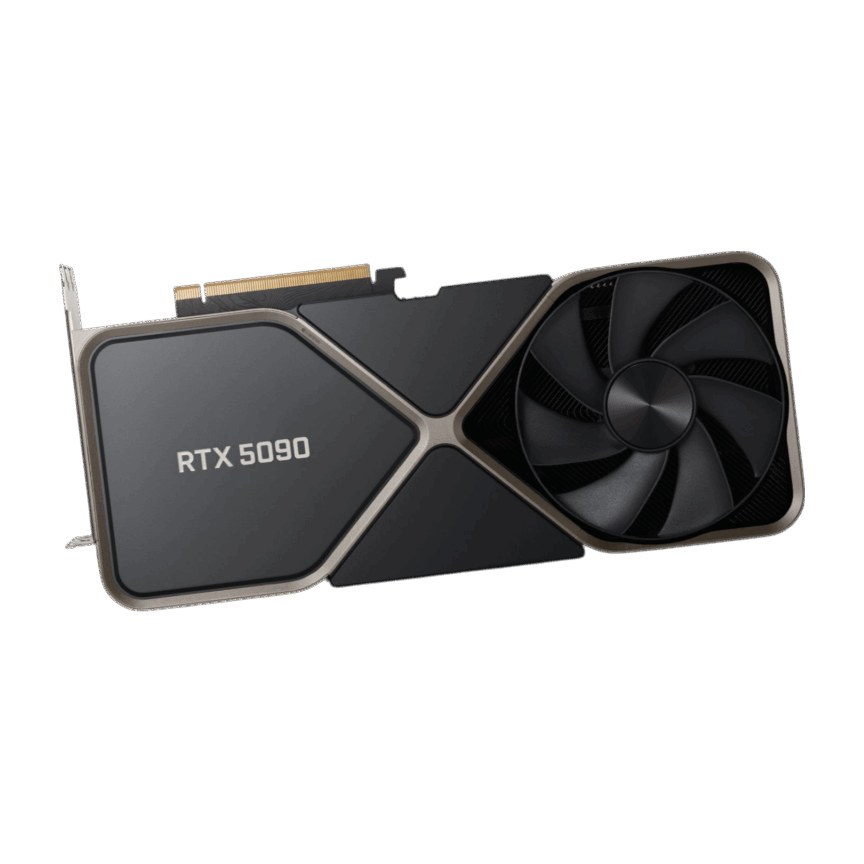 GeForce RTX 509032 ГБ · рабочие станции
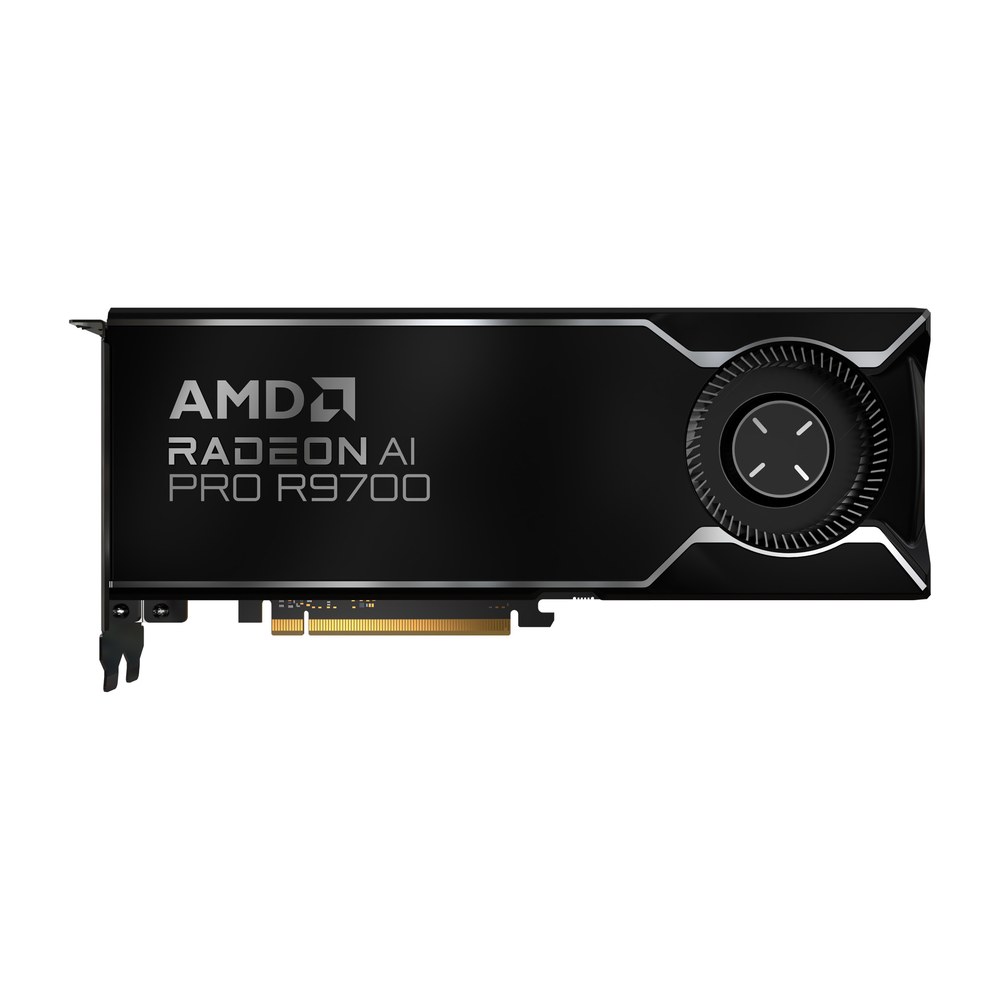 AMD Radeon AI PRO R970032 ГБ · бюджетная альтернатива
| Карта | Память | ГБ/с | BF16, TFLOPS* | FP8, TFLOPS* | Вт | Исполнение | Для чего |
|---|---|---|---|---|---|---|---|
| RTX 5060 Ti 16GB | 16 ГБ | 448 | ~47 | ~95 | 180 | игровая, активная | Пилоты, модели до 14 млрд, эмбеддинги |
| RTX 3090 24GB (б/у) | 24 ГБ | 936 | ~71 | — | 350 | игровая, активная | Самая дешёвая быстрая память, стенды |
| Radeon AI PRO R9700 | 32 ГБ | 640 | ~191 | ~383 | 300 | турбина, 2 слота | Бюджетные многокарточные сборки (ROCm) |
| GeForce RTX 5090 | 32 ГБ | 1792 | ~210 | ~419 | 575 | игровая, 2–3,5 слота | Рабочие станции, модели до 32 млрд |
| L40S | 48 ГБ | 864 | 362 | 733 | 350 | серверная, пассивная | Предыдущее поколение, видеоаналитика + ИИ |
| RTX PRO 6000 Max-Q | 96 ГБ | 1792 | ~440 | ~880 | 300 | турбина, 2 слота | Плотные рабочие станции и серверы до 8 карт |
| RTX PRO 6000 Server Edition | 96 ГБ | 1597 | ~500 | ~1000 | 600 | серверная, пассивная | Основной выбор для инференса в 2026 |
| H200 NVL | 141 ГБ | 4800 | 835 | 1671 | 600 | серверная, пассивная, NVLink-мост | Крупные модели, много пользователей, дообучение |
| AMD Instinct MI350P новинка 2026 | 144 ГБ | 4000 | 1150 | 2300 | 450–600 | серверная, пассивная, 2 слота | Альтернатива H200 NVL на AMD (ROCm), FP4/FP6 |
| HGX B200 / B300 (8 GPU) | 180–288 ГБ | 8000 | ~2250 | ~4500 | 1000+ | модули SXM, плата на 8 GPU | Обучение, модели на 1 трлн+ параметров |
* Плотные (dense) значения без учёта разреженности. Маркетинговые цифры производителей обычно указаны с разреженностью (×2) и в FP4 (×4 к BF16). У игровых GeForce скорость тензорных операций с FP32-накоплением (которое используют фреймворки) вдвое ниже «паспортной» — в таблице указана реальная. Источники: спецификации NVIDIA и AMD. AMD Instinct MI350P представлена в мае 2026 года: PCIe-карта на 144 ГБ HBM3E, которая ставится в те же 4U-серверы на 8 GPU, что и H200 NVL; поставки в Россию — под заказ.
6. Популярные открытые модели: размеры и требования
В таблице — модели, которые наши клиенты чаще всего запрашивают для локального развёртывания в 2026 году. Все распространяются с открытыми весами под лицензиями Apache 2.0 или MIT, то есть их можно использовать в коммерческих задачах.
| Модель | Разработчик | Тип | Параметры (всего / активно) | Контекст | Веса BF16 | FP8 | 4 бита |
|---|---|---|---|---|---|---|---|
| GigaChat 3.1 Lightning | Сбер | MoE | 10 / 1,8 млрд | — | 20 ГБ | 10 ГБ | 6 ГБ |
| gpt-oss-20b | OpenAI | MoE | 21 / 3,6 млрд | 128K | — | — | ~13 ГБ (родной MXFP4) |
| Qwen3.8-27B | Alibaba | плотная, мультимодальная | 27 млрд | 262K | 56 ГБ | 28 ГБ | 15 ГБ |
| Gemma 4 31B | плотная, мультимодальная | 30,7 млрд | 256K | 61 ГБ | 31 ГБ | 17 ГБ | |
| T-Pro 2.1 | Т-Банк | плотная | ~33 млрд | — | 66 ГБ | 33 ГБ | 18 ГБ |
| gpt-oss-120b | OpenAI | MoE | 117 / 5,1 млрд | 128K | — | — | ~63 ГБ (родной MXFP4) |
| Qwen3.5-122B-A10B | Alibaba | MoE | 122 / 10 млрд | 262K | 244 ГБ | 124 ГБ | 68 ГБ |
| DeepSeek V4 Flash | DeepSeek | MoE | 284 / 13 млрд | 1M | — | — | ~160 ГБ (родной FP4+FP8) |
| GLM-5.3-Flash | Z.ai | MoE, мультимодальная | 320 / 18 млрд | 1M | 640 ГБ | ~330 ГБ | 180 ГБ |
| Qwen3.5-397B-A17B | Alibaba | MoE | 397 / 17 млрд | 262K | 794 ГБ | 405 ГБ | 222 ГБ |
| GigaChat 3.5 Ultra | Сбер | MoE, гибридное внимание | 432 / 28 млрд | 262K | 864 ГБ | ~440 ГБ | 242 ГБ |
| DeepSeek V4 Pro | DeepSeek | MoE | 1,6 трлн / 49 млрд | 1M | — | — | ~865 ГБ (родной FP4+FP8) |
Параметры и лицензии — по карточкам моделей на Hugging Face и официальным анонсам разработчиков. Объёмы весов округлены; «—» в колонке контекста — уточняйте по карточке конкретной версии.
7. Минимальное и оптимальное железо для каждой модели
Минимум — модель запускается и даёт комфортную скорость для 1–10 пользователей с умеренным контекстом, допустимо 4-битное сжатие. Оптимум — промышленная эксплуатация: формат FP8 или исходный, 20–100 одновременных запросов, контекст 32K+, запас на рост.
| Модель | Минимум | Оптимум | Почему так | Чем можно заменить |
|---|---|---|---|---|
| GigaChat 3.1 Lightning gpt-oss-20b | 1 × RTX 5060 Ti 16 ГБ | 1 × RTX 5090 32 ГБ или RTX PRO 4500 32 ГБ | Весит 6–20 ГБ; активных параметров мало — модель очень быстрая даже на недорогих картах | Мини-ПК на Ryzen AI Max+ 395 (128 ГБ), Jetson AGX Thor для edge-задач |
| Qwen3.8-27B Gemma 4 31B T-Pro 2.1 | 1 × RTX 5090 (4 бита) или 2 × RTX 3090 | 1 × RTX PRO 6000 96 ГБ (FP8, 30–60 пользователей); 2 карты — от 100 пользователей | Плотные модели: каждый токен читает все 27–33 млрд параметров, поэтому важна пропускная способность памяти; FP8 + KV-кеш = 50–80 ГБ | 2 × R9700 (64 ГБ) — дешевле, но медленнее; L40S 48 ГБ — с 4-битным сжатием |
| gpt-oss-120b | 1 × RTX PRO 6000 96 ГБ; для 1–5 пользователей — GB10 или Ryzen AI Max+ 395 с 128 ГБ | 2 × RTX PRO 6000 или 1 × H200 NVL 141 ГБ | 63 ГБ весов + кеш помещаются в одну 96-гигабайтную карту; 5 млрд активных параметров дают 100+ ток/с | 4 × Radeon AI PRO R9700 (128 ГБ) — в 2 раза дешевле, но экосистема AMD (ROCm) и медленнее генерация |
| Qwen3.5-122B-A10B | 1 × RTX PRO 6000 (4 бита, небольшой контекст) | 2 × RTX PRO 6000 (FP8) или 2 × H200 NVL | 124 ГБ в FP8 не помещаются в одну карту 96 ГБ, а в H200 NVL остаётся мало места под кеш | 4 × R9700 (128 ГБ) с 4-битным сжатием |
| DeepSeek V4 Flash | 2 × RTX PRO 6000 (192 ГБ), короткий контекст | 4 × RTX PRO 6000 (384 ГБ) или 2–4 × H200 NVL | ~160 ГБ весов в родном формате; длинный контекст до 1M и агентные сценарии требуют запаса под кеш | Гибрид: EPYC + 768 ГБ DDR5 + 1 GPU (KTransformers / llama.cpp) — 10–25 ток/с для 1–3 пользователей |
| GLM-5.3-Flash Qwen3.5-397B-A17B | 4 × RTX PRO 6000 (4 бита) | 8 × RTX PRO 6000 (FP8) или 4 × H200 NVL с NVLink-мостом | 330–405 ГБ в FP8: в 384 ГБ не остаётся места под кеш, нужен сервер на 8 карт или 4 карты по 141 ГБ | 8 × R9700 (256 ГБ) с 4-битным сжатием — бюджетно, но с рисками совместимости ПО |
| GigaChat 3.5 Ultra | 4 × RTX PRO 6000 (4 бита) или 4 × H200 NVL (FP8, мало пользователей) | 8 × RTX PRO 6000 (768 ГБ) или 8 × H200 NVL (1128 ГБ) | ~440 ГБ в FP8 и 28 млрд активных параметров — нужна и память, и пропускная способность | Для задач, где не нужен флагман, — GigaChat 3.1 Lightning или Qwen3.8-27B на одной карте |
| DeepSeek V4 Pro | 8 × H200 NVL (1128 ГБ) | Сервер HGX B200/B300 на 8 GPU или кластер | ~865 ГБ весов: в 8 × 96 ГБ (768 ГБ) не помещается | DeepSeek V4 Flash — в 5 раз меньше при близком качестве на типовых задачах |
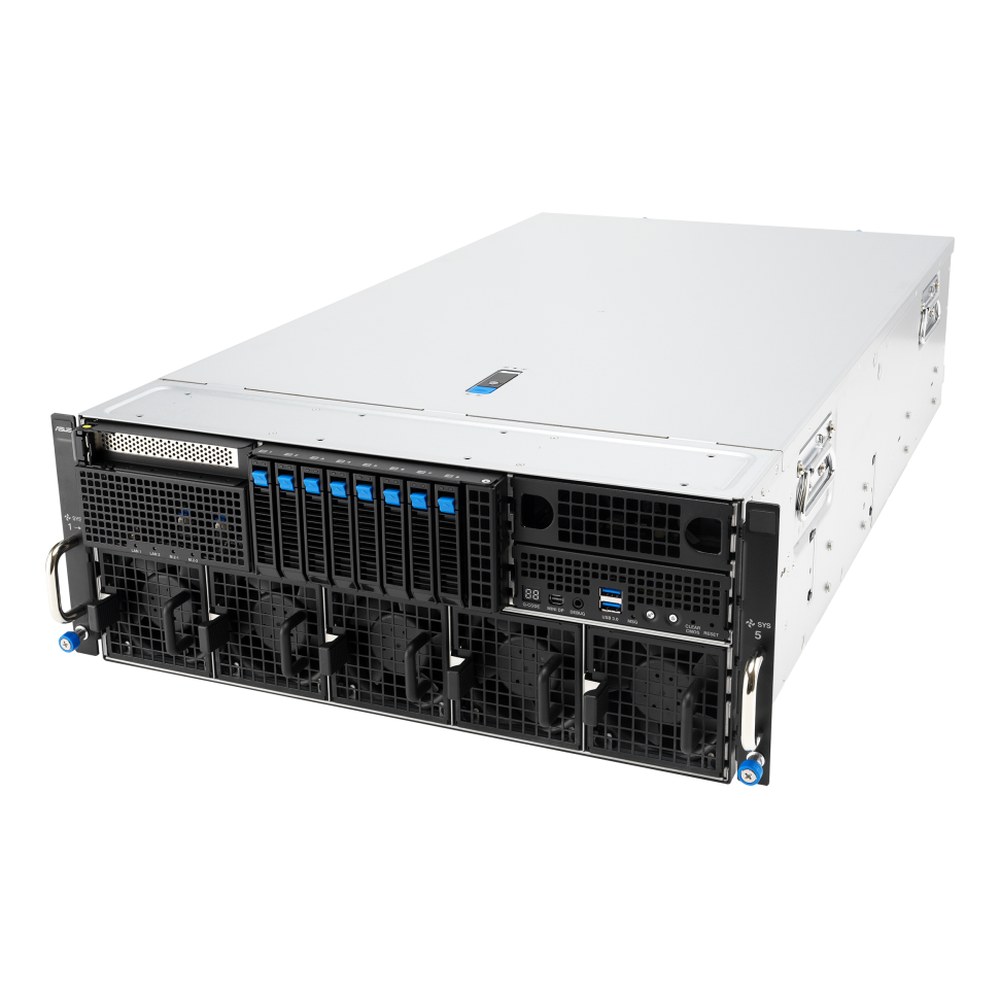 ASUS ESC8000A-E13P4U, до 8 × GPU 600 Вт, AMD EPYC 9005
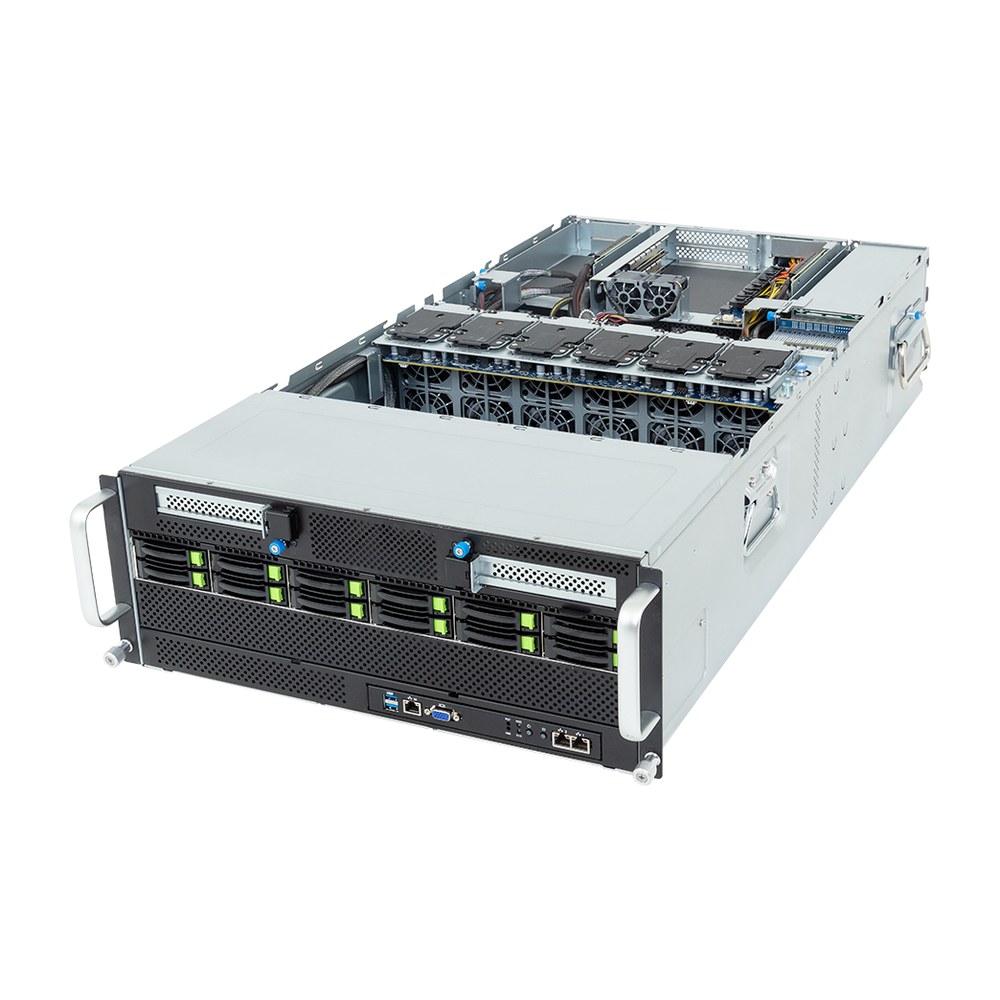 GIGABYTE G494-ZB4-AAP24U, 8 × H200 NVL с NVLink-мостами
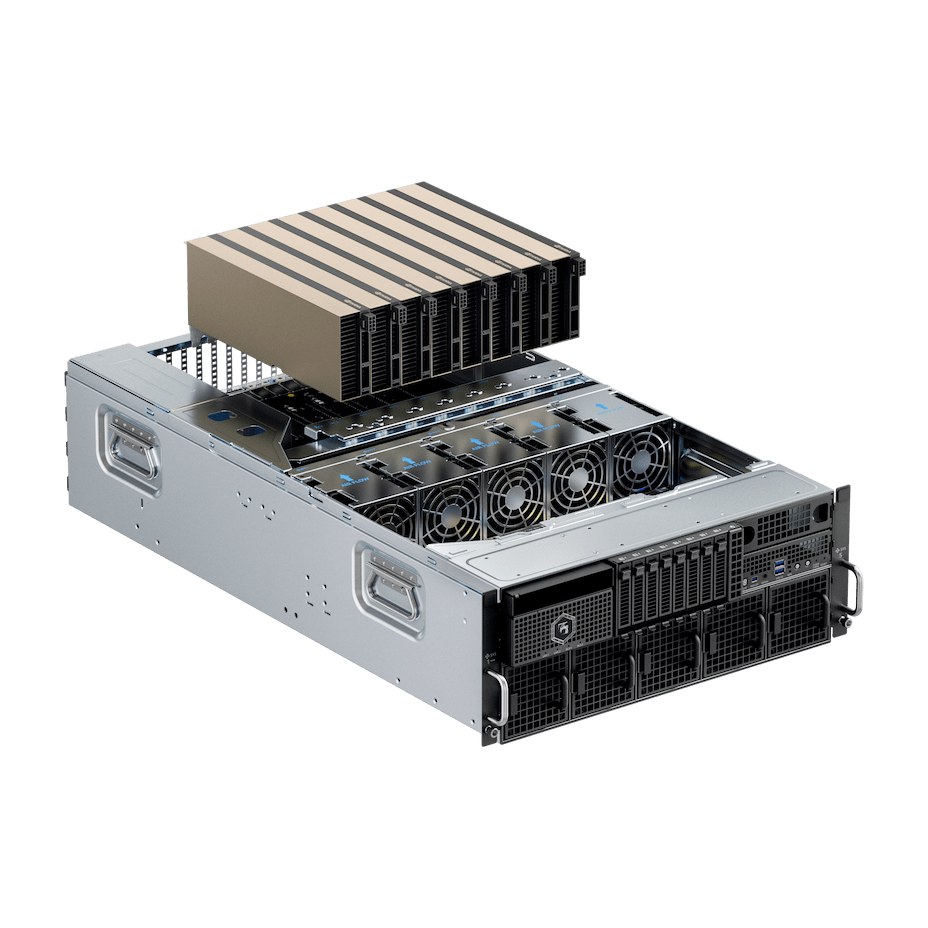 Digital Razor HPC 8000российский GPU-сервер на 8 карт
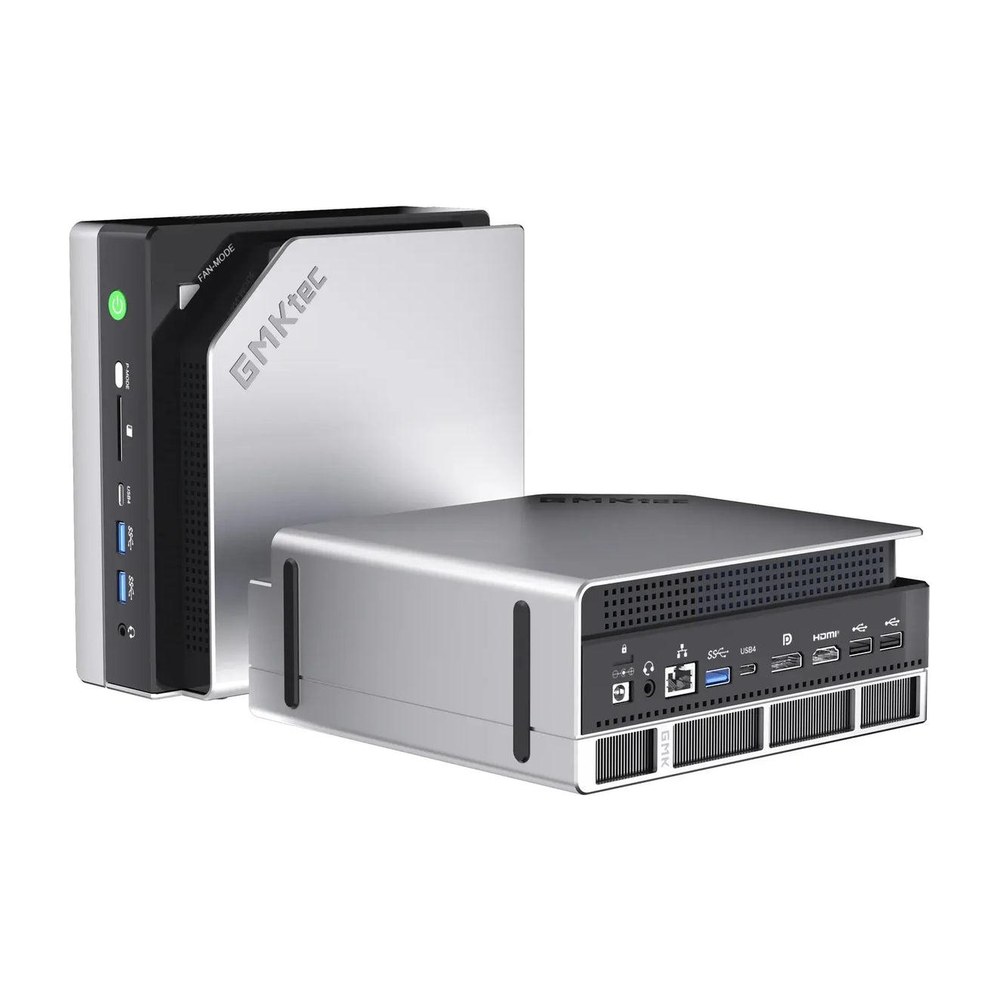 GMKtec EVO-X2, 128 ГБмини-ПК для пилота на 1–5 пользователей
8. Чем можно заменить и на чём нельзя экономить
| Вместо | Можно взять | Что выигрываем | Чем платим |
|---|---|---|---|
| RTX PRO 6000 96 ГБ | 3 × Radeon AI PRO R9700 32 ГБ | Цена ниже в 3 раза при той же памяти (~0,7 млн ₽ против ~2,2 млн ₽ за Max-Q) | Память 640 ГБ/с вместо 1792 — генерация медленнее; три слота вместо одного; экосистема ROCm. Вариант «3 × RTX 5090» после подорожания 2026 года потерял смысл: стоит как одна RTX PRO 6000 |
| H200 NVL 141 ГБ | RTX PRO 6000 Server Edition 96 ГБ | Дешевле почти вдвое, поддержка FP4 | Пропускная способность памяти в 3 раза ниже — медленнее генерация на крупных моделях; нет NVLink |
| Видеопамять | Оперативная память сервера (выгрузка экспертов MoE на CPU) | Крупная MoE-модель запускается на 1 GPU | Скорость 10–25 ток/с, подходит для 1–3 пользователей, не для отдела |
| Исходный формат BF16 | FP8 или 4-битное сжатие | В 2–4 раза меньше памяти и выше скорость | FP8 — почти без потерь; 4 бита — небольшое падение качества на сложных задачах |
| NVIDIA | AMD Radeon AI PRO R9700 / Instinct | Дешевле память и TFLOPS | Экосистема ROCm: не все модели и оптимизации доступны сразу после выхода |
| Новый сервер | Аренда GPU-сервера с правом выкупа | Старт без капитальных затрат, можно сменить конфигурацию | Ежемесячные платежи |
9. Шпаргалка: 10 вопросов клиенту перед расчётом
- Какая модель нужна или какие задачи она будет решать (чат, поиск по документам, код, анализ изображений)?
- Сколько пользователей всего и сколько работают одновременно в пиковый час?
- Какой объём текста в одном запросе: короткие вопросы или документы на десятки страниц?
- Какая скорость ответа нужна: «как в ChatGPT» (20+ ток/с) или допустима пакетная обработка?
- Будет ли дообучение на своих данных?
- Планируется ли рост: больше пользователей, модель крупнее, второй сервер?
- Где будет стоять сервер: ЦОД, серверная клиента, офис? Какая мощность ввода на стойку?
- Нужна ли работа без интернета (изолированный контур)?
- Требования к происхождению оборудования (реестр Минпромторга, импортозамещение)?
- Бюджет и форма: покупка, лизинг, аренда?
Рассчитаем конфигурацию, развернём нейросеть и подключим её к вашим системам — покупка или аренда с правом выкупа.
Локальная нейросеть под ключКаталог GPU и серверов